

NOT IN no PostgreSQL: 141 ms com 200 mil linhas, mais de 3 minutos com 400 mil
Medimos a virada do NOT IN no PostgreSQL 18, perto de 262 mil linhas, e o NULL que zera o resultado. O NOT EXISTS fez o mesmo trabalho em 272 ms.

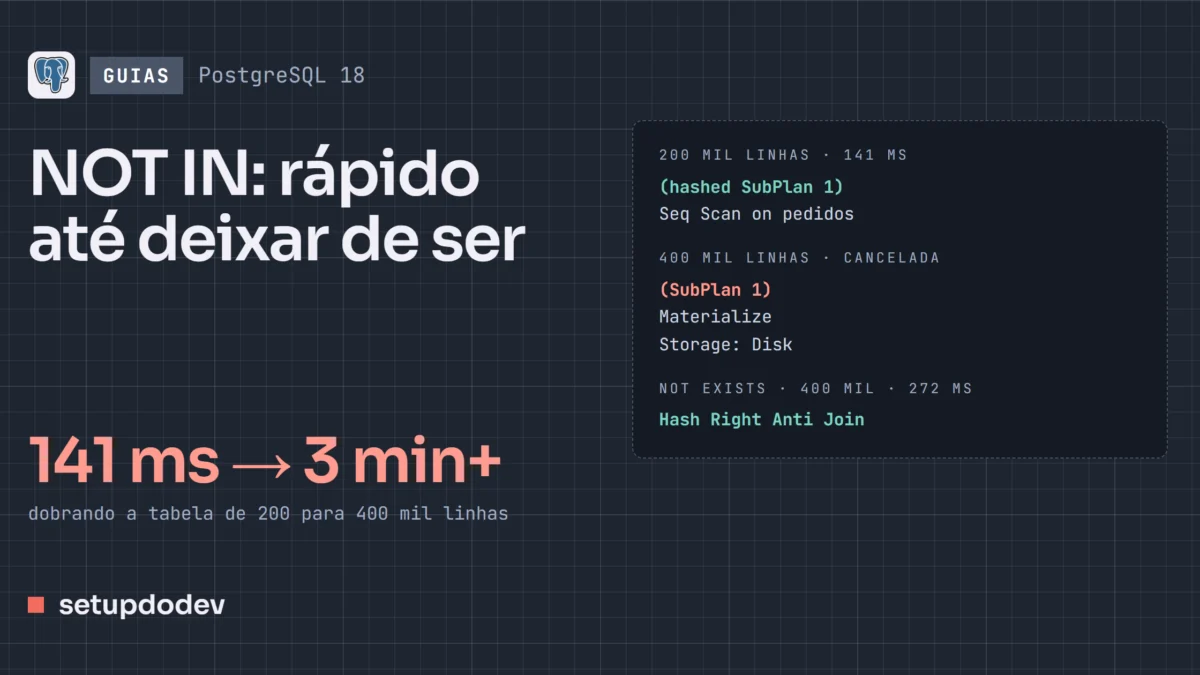
A pergunta é comum: quais clientes nunca fizeram um pedido? Com 100 mil clientes e 200 mil pedidos, a consulta abaixo levou 141 ms. Dobramos os pedidos para 400 mil e ela passou de 3 minutos, quando o statement_timeout a cancelou. Mesma consulta, mesma máquina, nenhum erro antes disso.
SELECT count(*) FROM clientes
WHERE id NOT IN (SELECT cliente_id FROM pedidos);
O NOT IN com subconsulta tem dois problemas separados, um de desempenho e um de resultado, e os dois nascem do mesmo lugar. Os testes são do PostgreSQL 18.4 no Windows, com o work_mem padrão de 4 MB, em tabelas temporárias. Os tempos são da nossa máquina; o que importa é a proporção.
A virada perto de 262 mil linhas
O EXPLAIN ANALYZE mostra a diferença em uma palavra. Com 200 mil pedidos:
Seq Scan on clientes
  Filter: (NOT (ANY (id = (hashed SubPlan 1).col1)))
  SubPlan 1
    ->  Seq Scan on pedidos
Com 400 mil, o hashed some:
Seq Scan on clientes
  Filter: (NOT (ANY (id = (SubPlan 1).col1)))
  SubPlan 1
    ->  Materialize
          Storage: Disk  Maximum Storage: 5469kB
          ->  Seq Scan on pedidos
Com hashed, o banco monta uma tabela de hash uma vez e consulta cada cliente nela. Sem ele, relê a lista de pedidos para cada cliente, até achar ou chegar ao fim. O planejador só escolhe o hash se ele couber na memória. Fizemos uma busca binária no tamanho da tabela e o plano virou entre 262.109 linhas (ainda com hash) e 262.500 (sem). Não decore o número, porque ele acompanha o work_mem: em 16 MB, os mesmos 400 mil voltaram ao hash e levaram 338 ms.
Para sentir o custo do lado errado da virada, reduzimos os clientes. Com os 400 mil pedidos, os primeiros 1.000 clientes levaram 17 segundos. Quinhentos ids que não têm pedido nenhum, o pior caso, porque o banco lê a lista até o fim toda vez, levaram 62 segundos: cerca de 124 ms por cliente. Com 20 mil clientes, cancelamos em 100 segundos.
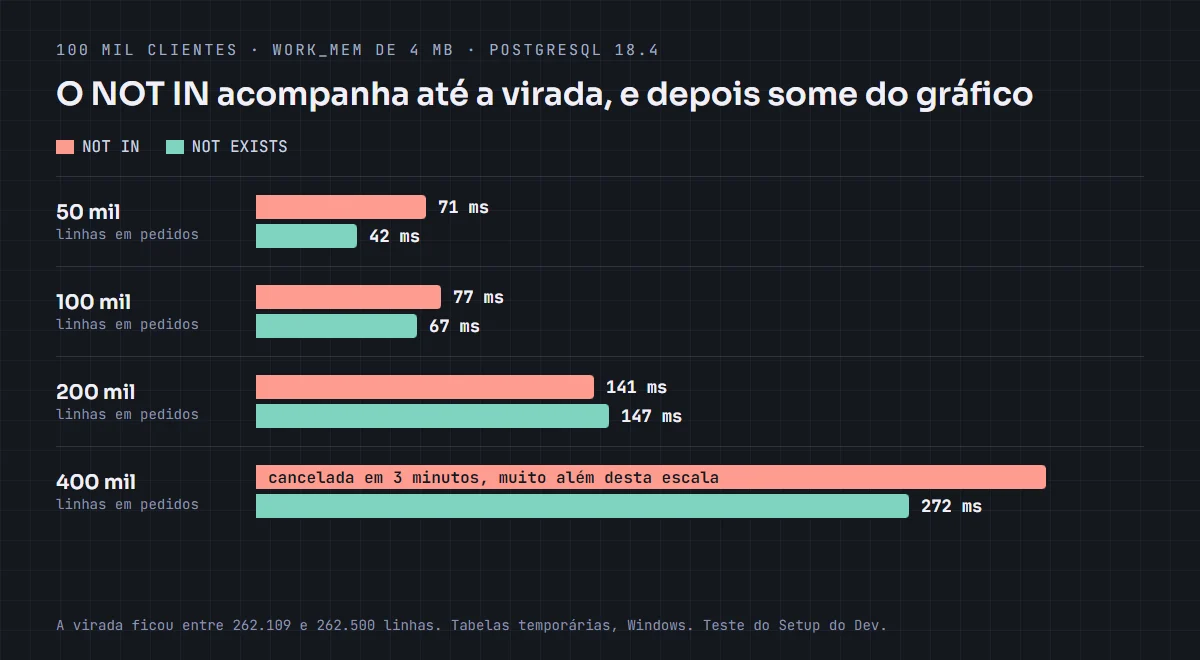
É o que torna esse caso traiçoeiro. A consulta passa em desenvolvimento, passa em homologação e passa meses em produção. Um dia a tabela cruza a linha, as estatísticas mudam depois de um ANALYZE e a mesma consulta fica mais de mil vezes mais lenta, sem deploy nenhum para culpar. A wiki do PostgreSQL descreve esse mesmo comportamento.
O que não resolve
Tentamos as três coisas que vêm primeiro à cabeça, com 400 mil pedidos. Filtrar com WHERE cliente_id IS NOT NULL na subconsulta deu o mesmo plano com Materialize. Declarar as duas colunas como NOT NULL também. E criar um índice em pedidos(cliente_id) não salvou: os 20 mil clientes foram cancelados de novo em 100 segundos.
Subir o work_mem resolve hoje e só empurra a virada para mais longe. Em 1 milhão de clientes e 2 milhões de pedidos, com 256 MB, o NOT IN levou 2,3 segundos. Com os 4 MB padrão, cancelamos depois de 2 minutos e 21 segundos sem resposta.
Um NULL e a resposta vira zero
O segundo problema não deixa nada lento. Numa tabela de 50 mil pedidos, a consulta encontrava 61.657 clientes sem pedido. Inserimos uma única linha com cliente_id nulo:
INSERT INTO pedidos (id, cliente_id) VALUES (0, NULL);

SELECT count(*) FROM clientes
WHERE id NOT IN (SELECT cliente_id FROM pedidos);
-- 0

SELECT count(*) FROM clientes c
WHERE NOT EXISTS (SELECT 1 FROM pedidos p WHERE p.cliente_id = c.id);
-- 61657
Zero, sem erro nem aviso, e um relatório de “clientes para reativar” sai vazio. A razão é a lógica de três valores do SQL. Perguntar se 1 está em (2, NULL) não dá falso, porque o banco não sabe o que aquele nulo é:
SELECT 1 NOT IN (2, NULL);                -- NULL
SELECT 1 NOT IN (1, NULL);                -- false
SELECT 1 NOT IN (SELECT 1 WHERE false);   -- true
O NOT IN nunca devolve verdadeiro com um nulo na lista, e o WHERE só fica com o verdadeiro. Um nulo aparece fácil: uma coluna opcional, um ON DELETE SET NULL, uma importação com campo em branco. É também por causa dessa regra que, segundo a wiki, o planejador não consegue transformar o NOT IN numa anti-join, e por isso só restam os dois planos acima.
O que usar no lugar
SELECT count(*) FROM clientes c
WHERE NOT EXISTS (
  SELECT 1 FROM pedidos p WHERE p.cliente_id = c.id
);
O plano vira Hash Right Anti Join, que não tem essa virada e ignora o nulo do jeito que quase sempre se quer. Com 100 mil clientes e 400 mil pedidos, os tempos foram estes, todos os que terminaram com a mesma resposta (11.115 clientes):
NOT EXISTS: 272 msEXCEPT: 310 msLEFT JOIN ... WHERE p.id IS NULL: 359 msNOT INcom 4 MB: cancelado em 3 minutos
Em 1 milhão por 2 milhões, o NOT EXISTS levou 3,0 segundos e o LEFT JOIN, 3,5. Os 2,3 segundos do NOT IN com hash foram os melhores dessa rodada: quando ele cabe na memória, não é lento. Mesmo assim, ficamos com o NOT EXISTS sempre, porque perder 0,7 segundo no melhor caso custa bem menos que descobrir a virada em produção.
A lista fixa continua liberada. status NOT IN ('cancelado', 'estornado') não tem subconsulta nem nulo, e a wiki considera esse uso natural. O cuidado é com a lista montada a partir de um parâmetro que pode vir nulo.
Como achar os que você já tem
No código, um grep -rniE "NOT[[:space:]]+IN[[:space:]]*\([[:space:]]*SELECT" . pega os casos escritos em uma linha. O que quebra a linha depois do IN escapa, então procure também só por NOT IN. No banco, rode o EXPLAIN das consultas suspeitas e procure um SubPlan sem a palavra hashed. Se aparecer um com hashed numa tabela que cresce, ele só ainda não virou.
Fonte: Wiki do PostgreSQL: Don’t Do This
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário