

EXPLAIN ANALYZE no PostgreSQL: como ler o plano de uma consulta lenta
Testamos com 2 milhões de pedidos no PostgreSQL 18: a busca por cliente caiu de 385 ms para 0,8 ms, e o plano mostrou o motivo, linha por linha.

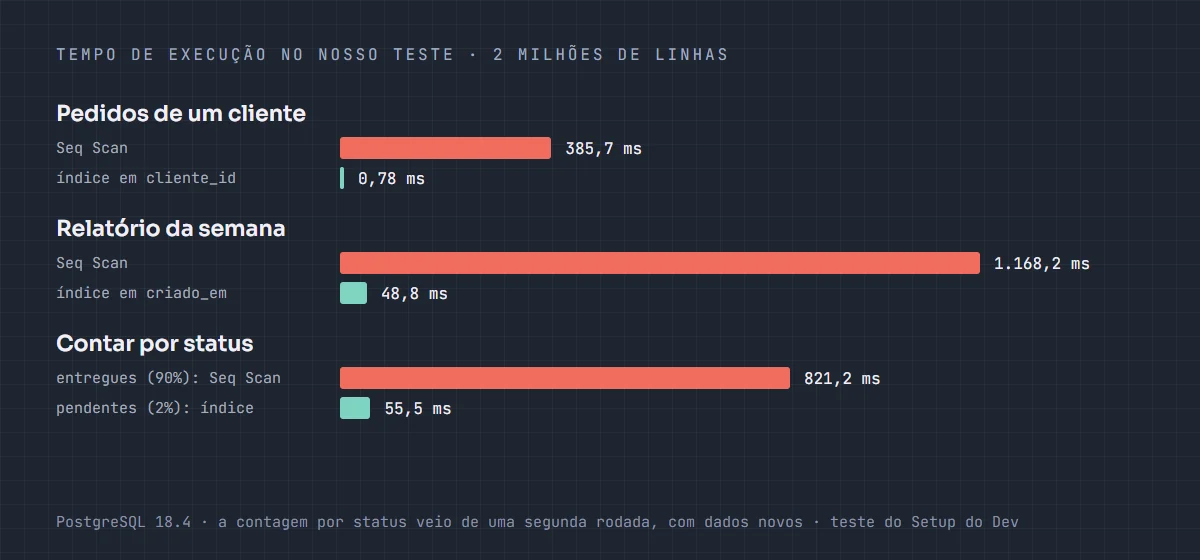
Uma consulta que buscava os pedidos de um cliente levava 385 milissegundos numa tabela de 2 milhões de linhas. Depois de um índice, passou a levar 0,8 ms, quase 500 vezes menos. O número diz que melhorou; o EXPLAIN ANALYZE diz por quê, e é ele que mostra onde mexer quando a consulta lenta é a sua.
Os planos deste guia saíram de um PostgreSQL 18.4 aqui da redação, numa tabela temporária, que some quando a conexão fecha. O teste inteiro cabe em duas consultas:
CREATE TEMPORARY TABLE pedidos (
  id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  cliente_id int NOT NULL,
  status text NOT NULL,
  criado_em timestamptz NOT NULL,
  total numeric(10,2) NOT NULL);

INSERT INTO pedidos (cliente_id, status, criado_em, total)
SELECT (random() * 99999)::int + 1,
       CASE WHEN r < 0.90 THEN 'entregue' WHEN r < 0.98 THEN 'cancelado' ELSE 'pendente' END,
       now() - random() * interval '730 days',
       round((random() * 900 + 10)::numeric, 2)
FROM (SELECT random() AS r FROM generate_series(1, 2000000)) s;
São 100 mil clientes, 90% dos pedidos entregues, 2% pendentes e datas espalhadas por dois anos.
A primeira leitura: um Seq Scan
Sem índice nenhum além da chave primária, a busca por um cliente devolve este plano:
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, status, total FROM pedidos WHERE cliente_id = 4242;

Seq Scan on pedidos  (cost=0.00..41667.00 rows=21 width=23)
                     (actual time=18.182..385.617 rows=17.00 loops=1)
  Filter: (cliente_id = 4242)
  Rows Removed by Filter: 1999983
  Buffers: local hit=16667
Execution Time: 385.660 ms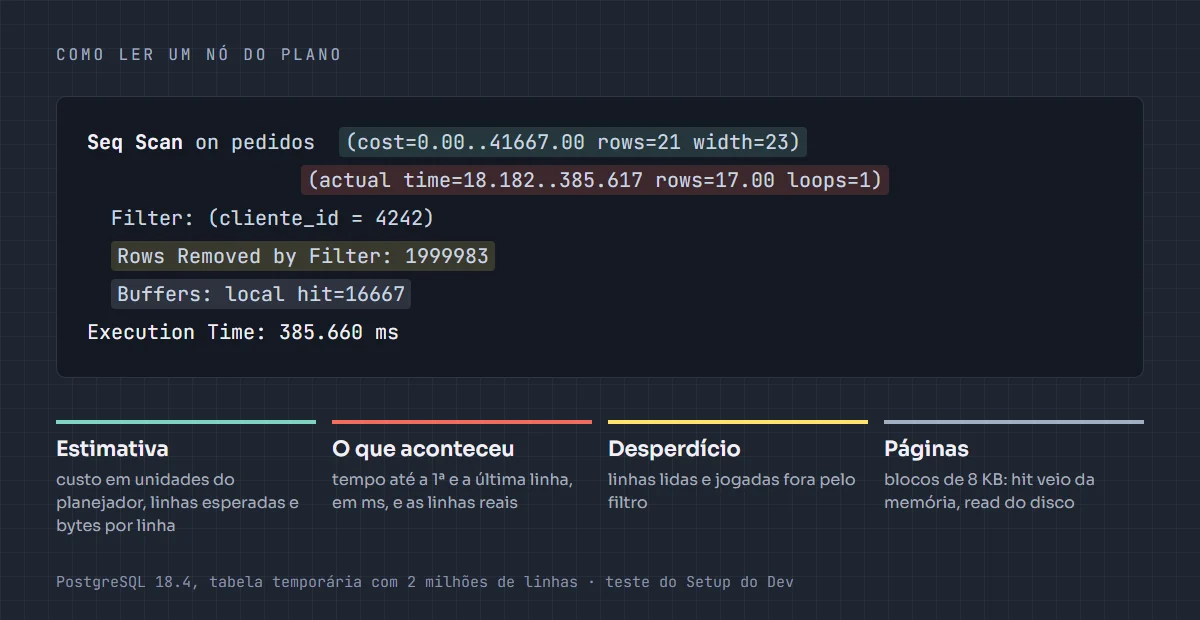
Cada linha do plano é um nó, e cada nó tem duas metades. A primeira, entre parênteses, é a estimativa do planejador: o custo, em unidades arbitrárias que só servem para comparar planos, as linhas que ele espera devolver (21) e a largura média delas em bytes. A segunda é o que aconteceu: o tempo até a primeira e até a última linha e as linhas de verdade (17).
O resto do diagnóstico está nas linhas de baixo. Seq Scan é a leitura da tabela inteira; Rows Removed by Filter diz que ele descartou 1.999.983 linhas para achar 17; e Buffers conta 16.667 páginas de 8 KB, uns 130 MB lidos da memória. Aparece local porque a tabela é temporária; numa tabela comum, a palavra é shared, e o read ao lado do hit indica o que veio do disco.
No PostgreSQL 18, o BUFFERS já vem ligado no EXPLAIN ANALYZE, e as linhas aparecem com duas casas decimais (17.00), segundo as notas da versão. Em versões anteriores, peça o BUFFERS à mão.
Quando a estimativa erra feio
Antes do ANALYZE, o mesmo plano dizia rows=7083 para as mesmas 17 linhas. Sem estatísticas, o planejador chuta. A documentação recomenda rodar o ANALYZE depois de qualquer carga grande, e lembra que o autovacuum não alcança tabelas temporárias. Estimativa e realidade muito distantes são a primeira coisa a procurar num plano ruim: é ali que o planejador escolhe o caminho errado.
O índice, e o plano lido de dentro para fora
Com CREATE INDEX ON pedidos (cliente_id), o plano muda de forma:
Bitmap Heap Scan on pedidos  (cost=4.58..82.75 rows=20 width=23)
                             (actual time=0.111..0.135 rows=17.00 loops=1)
  Recheck Cond: (cliente_id = 4242)
  Heap Blocks: exact=17
  ->  Bitmap Index Scan on pedidos_cliente_idx  (cost=0.00..4.58 rows=20 width=0)
                                               (actual time=0.077..0.078 rows=17.00 loops=1)
        Index Cond: (cliente_id = 4242)
        Index Searches: 1
Execution Time: 0.782 ms
O plano agora tem dois nós, e se lê de dentro para fora: o mais recuado roda primeiro. O Bitmap Index Scan consulta o índice e monta o mapa das páginas que têm o cliente 4242. O Bitmap Heap Scan visita só essas páginas: Heap Blocks: exact=17, uma página por pedido, contra as 16.667 de antes. O Index Searches, outra novidade do 18, conta quantas buscas o índice fez.
O relatório da semana repetiu a história. A soma dos pedidos dos últimos sete dias, agrupada por status, levou 1.168 ms com Seq Scan e 48,8 ms com um índice em criado_em, 24 vezes menos. Por cima do nó de leitura apareceu um HashAggregate, o nó que agrupa, com 32 kB de memória.
Quando o índice fica de fora
Numa segunda rodada, com índice também em status, contar os pedidos entregues continuou num Seq Scan de 821 ms. Com 90% da tabela no resultado, o planejador calcula que ler tudo em sequência sai mais barato que pular de página em página, e acerta. Para os pendentes, 2% da tabela, o índice entrou, e a contagem levou 55 ms. O Heap Blocks: exact=15183 mostra que esses 39 mil pedidos estavam espalhados por quase todas as páginas, e mesmo assim o índice compensou.
Por isso índice em coluna com poucos valores, como um status, só ajuda nas consultas pelos valores raros. Se o filtro comum é o valor que domina a tabela, o índice ocupa espaço e não entra no plano.
O cuidado que a documentação destaca
O ANALYZE do EXPLAIN executa o comando de verdade. Num SELECT, tudo bem; num UPDATE ou DELETE, os dados mudam. A página do EXPLAIN indica o caminho: BEGIN; EXPLAIN ANALYZE UPDATE ...; ROLLBACK;. E o tempo medido inclui o próprio trabalho de medir, então compare planos sempre na mesma máquina, com os dados já em memória.
Na prática, o roteiro é curto: rode o EXPLAIN (ANALYZE, BUFFERS), procure o nó que gasta mais tempo, compare rows estimado e real, e veja quantas linhas o filtro jogou fora. O índice certo costuma estar escrito ali.
Fontes: Documentação do PostgreSQL 18: EXPLAIN, Usando o EXPLAIN, Carga de dados, Notas do PostgreSQL 18
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário