

Índice parcial no PostgreSQL deixa o índice de uma fila 300 vezes menor
Num teste com 1 milhão de pedidos, o índice só dos pendentes ocupou 128 kB contra 39 MB, respondeu tão rápido quanto e acelerou a gravação 2,4 vezes.

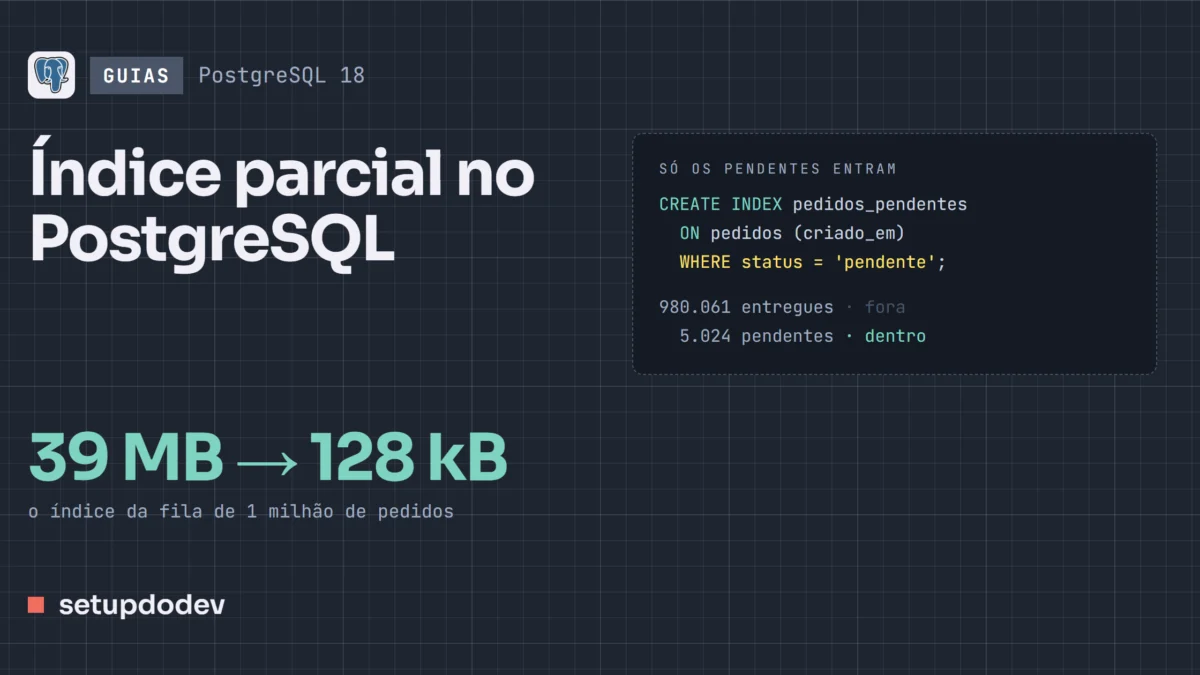
Toda tabela com uma coluna de status tem o mesmo desenho: quase todas as linhas estão num estado final (entregue, enviado, pago) e só uma fração pequena está esperando alguém. A fila de e-mails, os pedidos a cobrar, as tarefas pendentes. As consultas do dia a dia perguntam só por essa fração, mas o índice criado por reflexo, em (status, criado_em), guarda todas as linhas, inclusive as milhares que ninguém procura.
O índice parcial guarda só as linhas que passam num WHERE. Medimos a diferença numa tabela de 1 milhão de pedidos.
O teste
Rodamos no PostgreSQL 18.4, numa tabela temporária, com 980.061 pedidos entregues, 14.915 pagos e 5.024 pendentes. A consulta é a de quem consome a fila: os 20 pendentes mais antigos.
SELECT id, criado_em FROM pedidos
WHERE status = 'pendente'
ORDER BY criado_em LIMIT 20;
Sem índice, o banco leu a tabela inteira, 8.334 páginas, para achar os 5.024 pendentes e ordenar, em 74 a 78 milissegundos. Depois testamos os dois índices, um de cada vez:
-- o de sempre
CREATE INDEX pedidos_status_criado ON pedidos (status, criado_em);

-- o parcial: só os pendentes entram
CREATE INDEX pedidos_pendentes ON pedidos (criado_em)
WHERE status = 'pendente';
O parcial não leva a coluna status. Dentro dele, todas as linhas são pendentes, e guardar o mesmo valor 5 mil vezes não ajudaria a achar nada. A coluna indexada é a da ordenação, criado_em, e é ela que deixa o banco ler só os 20 primeiros, já na ordem, sem ordenar os 5 mil.
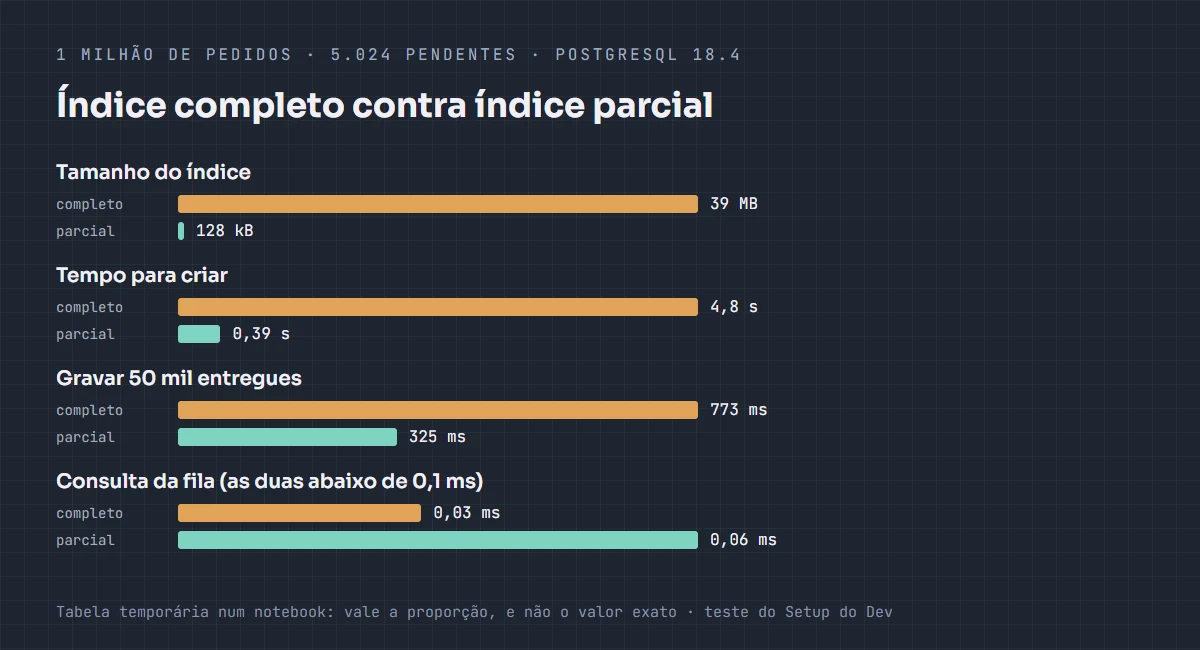
Os dois responderam a consulta em centésimos de milissegundo: 0,03 ms o completo e 0,06 ms o parcial, com o cache já quente, lendo 23 e 22 páginas. A diferença está no resto. O índice completo ocupou 39 MB e levou 4,8 segundos para ser criado. O parcial ocupou 128 kB e ficou pronto em 0,39 segundo. Num servidor de verdade, são 39 MB a menos disputando a memória com os dados que importam.
A gravação também fica mais leve
Todo INSERT e todo UPDATE que muda a coluna do índice precisa atualizar o índice também. No parcial, a linha que não passa no WHERE simplesmente não entra. Gravamos 50 mil pedidos já entregues com cada índice na tabela: 325 ms com o parcial e 773 ms com o completo, que tocou o dobro de páginas (301 mil contra 151 mil). Numa tabela que recebe muito pedido novo e só olha os pendentes, essa é a conta que pesa ao longo do dia.
Quando o PostgreSQL ignora o índice parcial
O banco só usa o índice parcial quando consegue provar que o WHERE da consulta está contido no do índice. A documentação avisa que ele reconhece casos simples, e que fora deles a condição precisa bater com a do índice. Pedindo os pendentes e os pagos juntos, com status IN ('pendente', 'pago'), o plano voltou a ler as 8.334 páginas da tabela, em 455 ms nessa rodada.
O segundo caso pega quem usa consulta preparada. A comparação com o índice acontece na hora de montar o plano, e não na de rodar, então um plano genérico, montado sem saber o valor do parâmetro, não pode usar o índice. Forçamos isso com plan_cache_mode = force_generic_plan:
PREPARE fila(text) AS
  SELECT id, criado_em FROM pedidos WHERE status = $1
  ORDER BY criado_em LIMIT 20;

-- plano genérico: Seq Scan on pedidos, Filter: (status = $1), 347 ms
No modo padrão (auto), o PostgreSQL percebeu que o plano sob medida saía muito mais barato e o manteve nas sete execuções do teste, contadas em pg_prepared_statements. O risco existe, mas tem solução simples: na consulta da fila, escreva o status no próprio SQL, e não como parâmetro. O valor é fixo de qualquer jeito.
Bônus: a regra “só um aberto por cliente”
O índice parcial também pode ser único, e aí ele vira uma regra de negócio que o banco garante. Um carrinho aberto por cliente, quantos fechados quiser:
CREATE UNIQUE INDEX um_aberto_por_cliente ON carrinhos (cliente_id)
WHERE status = 'aberto';
Com dois carrinhos fechados e um aberto do cliente 7, o segundo aberto foi recusado com duplicar valor da chave viola a restrição de unicidade "um_aberto_por_cliente". Dois cliques ao mesmo tempo chegam como duas transações, e um if no código perderia a corrida entre elas. O índice não perde.
Antes de indexar uma coluna de status, conte quantas linhas a consulta realmente procura. Se for uma fração pequena e sempre a mesma, o índice parcial entrega a mesma velocidade por uma fração do espaço. Os números aqui saíram de uma tabela temporária num notebook, e servem mais pela proporção do que pelo valor exato. Para conferir o plano das suas consultas, o EXPLAIN ANALYZE mostra qual índice foi usado e quantas páginas foram lidas.
Fonte: Documentação do PostgreSQL 18: índices parciais
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário