

Busca por texto em português no PostgreSQL, do LIKE ao índice GIN
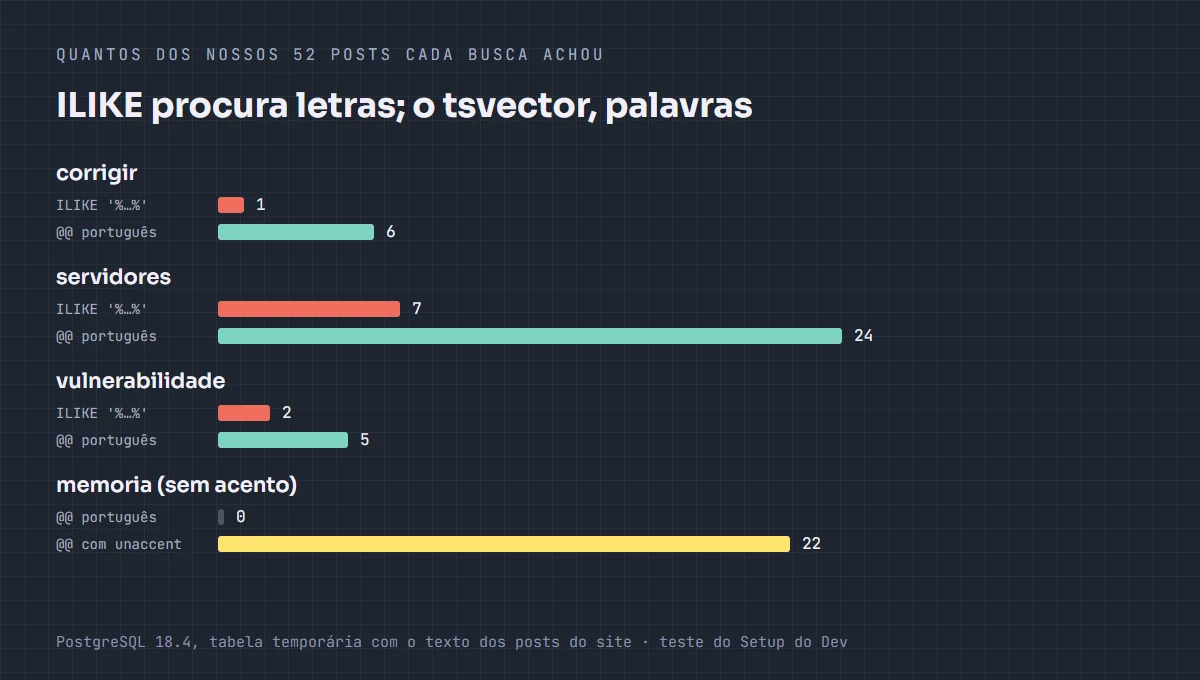
Nos nossos 52 posts, o ILIKE achou "corrigir" em 1 texto e o tsvector, em 6. Em 52 mil artigos, a busca caiu de 7,4 s para 1,9 ms com o índice GIN.

A caixa de busca de quase todo sistema começa com um WHERE titulo ILIKE '%termo%'. Funciona no primeiro dia e falha de dois jeitos depois: acha pouco, porque procura a sequência exata de letras, e fica lento, porque precisa ler a tabela inteira a cada busca. O PostgreSQL tem uma busca por texto própria que resolve os dois problemas, com suporte ao português, e este guia mostra o que ela faz usando como base os 52 posts que o Setup do Dev já publicou.
O teste rodou num PostgreSQL 18.4 aqui da redação, em tabelas temporárias, que somem quando a conexão fecha.
O que o to_tsvector guarda de uma frase
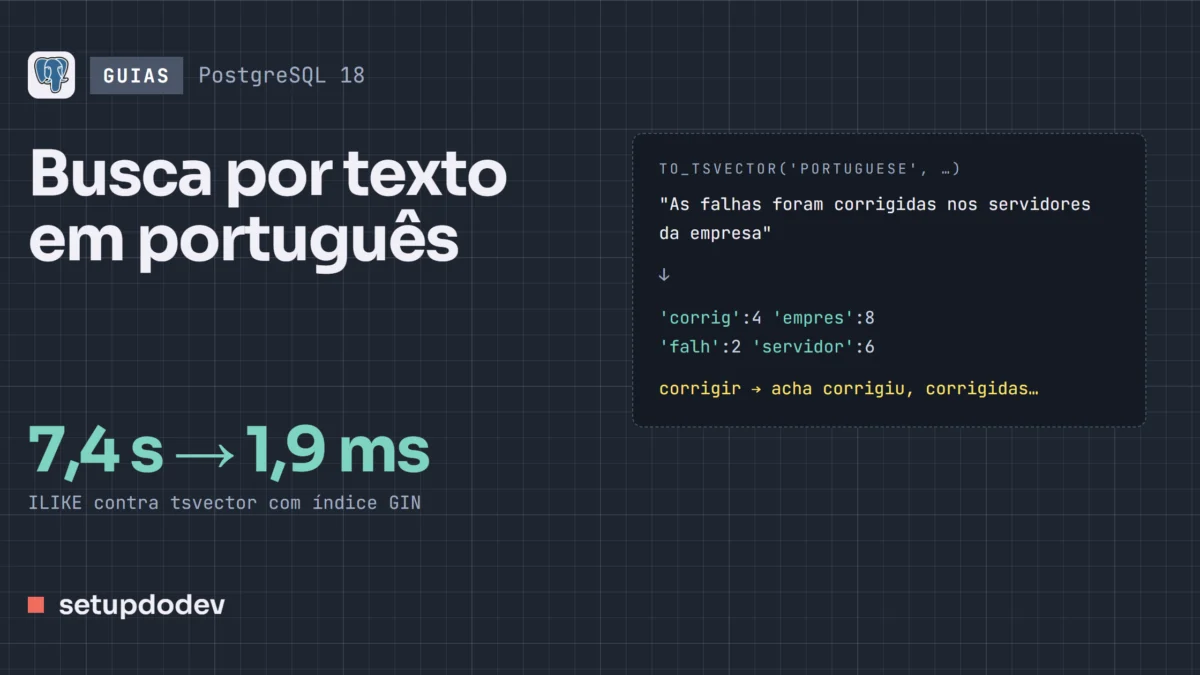
A busca não compara o texto como ele está escrito. Antes, o to_tsvector transforma a frase numa lista de radicais, os lexemas, e joga fora as palavras que não ajudam a achar nada:
SELECT to_tsvector('portuguese', 'As falhas foram corrigidas nos servidores da empresa');
-- 'corrig':4 'empres':8 'falh':2 'servidor':6

SELECT to_tsvector('portuguese', 'Corrigir, corrige, corrigida, correção');
-- 'correçã':4 'corrig':1,2,3
“As”, “foram”, “nos” e “da” saíram. “Corrigidas”, “corrigir” e “corrige” viraram o mesmo radical, corrig. “Correção” ficou com outro, e a busca por “corrigir” não vai achá-la. Os números depois dos dois-pontos são as posições na frase, que servem para busca de expressão e para a ordem dos resultados. Com a configuração 'simple' no lugar de 'portuguese', as palavras ficam inteiras e nada é descartado.
ILIKE contra @@ nos nossos posts
A comparação usa o operador @@, entre o texto convertido e a busca convertida pelo plainto_tsquery. Nos 52 posts:
| Busca | ILIKE ‘%…%’ | @@ (português) |
|---|---|---|
| corrigir | 1 | 6 |
| servidores | 7 | 24 |
| vulnerabilidade | 2 | 5 |
Na busca por “corrigir”, o @@ achou textos com corrigem, corrigia, corrigida, corrigidas, corrigido, corrigirem e corrigiu. O ILIKE só achou o post que tinha a palavra exata. Para quem pesquisa, a diferença é entre “não tem nada sobre isso” e seis resultados.
Acento e palavra em inglês
Dois casos tropeçaram no teste. O primeiro é o acento. “Memória” achou 22 posts; “memoria”, que é como muita gente digita no celular, achou zero. A extensão unaccent resolve, numa configuração de busca própria:
CREATE EXTENSION IF NOT EXISTS unaccent;
CREATE TEXT SEARCH CONFIGURATION pt_sem_acento (COPY = portuguese);
ALTER TEXT SEARCH CONFIGURATION pt_sem_acento
  ALTER MAPPING FOR hword, hword_part, word WITH unaccent, portuguese_stem;
Com ela, as duas grafias acharam os mesmos 22 posts. Criar extensão pede permissão de CREATE no banco. Para não deixar nada no banco de testes, rodamos esse trecho dentro de uma transação desfeita com ROLLBACK, e a configuração sumiu junto, porque no PostgreSQL até o CREATE volta atrás.
O segundo caso é próprio de texto técnico em português, cheio de termo em inglês. O radicalizador do português não sabe tirar o plural do inglês: “honeypots” fica honeypots, e a busca por “honeypot” volta vazia, mesmo com um post inteiro sobre o assunto. A saída é a busca por prefixo, to_tsquery('portuguese', 'honeypot:*'), que achou o post.
O que o usuário digita
O texto que vem da caixa de busca não deve ir para o to_tsquery: ele tem sintaxe própria, e um parêntese esquecido vira erro (erro de sintaxe em tsquery: "php & (falha"). O websearch_to_tsquery aceita a sintaxe que as pessoas já usam no Google e nunca dá erro de sintaxe:
"chave primária"          → 'chav' <-> 'primár'   3 posts
php -wordpress            → 'php' & !'wordpress'   3 posts
falha or vulnerabilidade  → 'falh' | 'vulner'      20 posts
As aspas buscam a expressão na ordem, o sinal de menos tira os resultados com a palavra, e o or aceita qualquer uma das duas.
A ordem e o trecho
Achar não basta: o resultado mais útil precisa vir primeiro. O setweight dá peso maior às palavras do título (A) do que às do corpo (D), e o ts_rank usa esses pesos. Na busca por “falha no servidor php”, só dois posts tinham as três palavras, os dois sobre o PHP2Shell, e saíram com 0,9964 e 0,9939. O ts_headline monta o trecho com as palavras marcadas, como os buscadores fazem. Esta é a saída do primeiro, do jeito que veio:
[servidores]-isca, os honeypots , que rodavam [PHP] 8.4.26 com Apache
e mod_[php] . Até então, o que as empresas de segurança tinham visto eram varreduras
O índice GIN: de 7,4 segundos para 1,9 milissegundo
Para medir a velocidade, multiplicamos os 52 posts por mil, num total de 52 mil artigos e 383 MB. A coluna de busca fica pronta na própria tabela, calculada pelo banco a cada gravação, e o índice GIN vai em cima dela:
CREATE TABLE artigos (
  id int GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  titulo text NOT NULL,
  corpo text NOT NULL,
  busca tsvector GENERATED ALWAYS AS (
    setweight(to_tsvector('portuguese', titulo), 'A') ||
    setweight(to_tsvector('portuguese', corpo), 'D')) STORED
);
CREATE INDEX ON artigos USING gin (busca);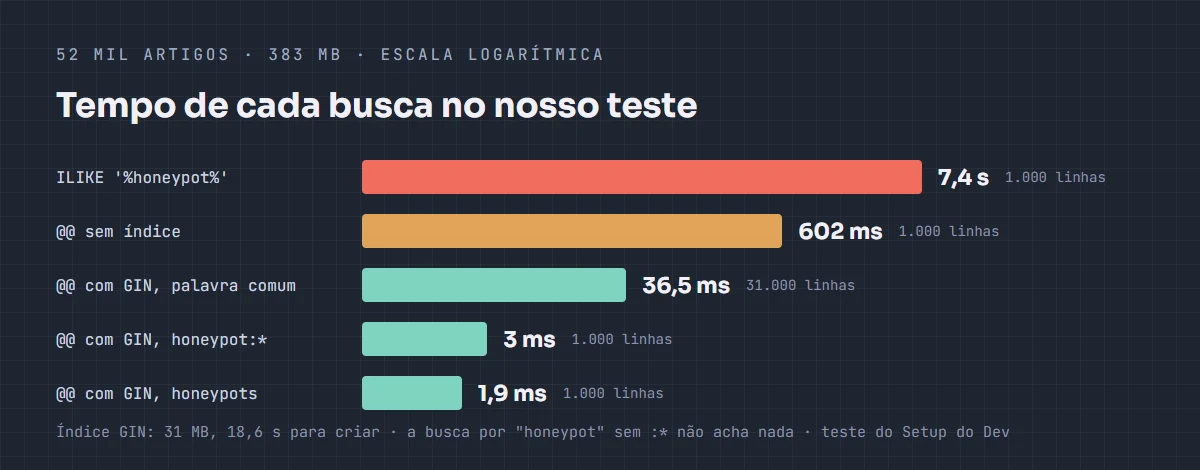
O ILIKE '%honeypot%' levou 7,4 segundos para achar as mil cópias do post, lendo a tabela inteira. A mesma busca com @@, ainda sem índice, levou 0,6 segundo, porque o texto já estava convertido na coluna. Com o GIN, 1,9 milissegundo, e 3 ms na busca por prefixo. Uma palavra que aparece em quase tudo, “código”, com 31 mil resultados, levou 36 ms. O ILIKE não usa esse índice: depois de criado, continuou em vários segundos.
A conta tem um outro lado. O índice ocupou 31 MB e levou 18,6 segundos para ser criado, e a carga das 52 mil linhas levou 93 segundos, porque o banco calcula o to_tsvector de cada artigo na hora de gravar. Para um site que publica algumas dezenas de textos por dia, isso não aparece; para uma importação em massa, vale criar o índice depois da carga.
A opinião do Setup do Dev: antes de subir um Elasticsearch ou um Meilisearch ao lado do banco, teste a busca do próprio PostgreSQL. Para um acervo de dezenas de milhares de textos, ela respondeu em milissegundos no nosso teste, sem mais um serviço para manter e sincronizar. Se uma busca específica continuar lenta, o EXPLAIN ANALYZE mostra onde está o tempo.
Fontes: Documentação do PostgreSQL 18: busca por texto, Controle da busca (websearch_to_tsquery, ts_rank, ts_headline), Índices para busca por texto, unaccent
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário