

O preg_match do PHP desiste do regex lento e devolve false, e o validador deixa tudo passar
No PHP 8.5, um regex comum aceitou uma tag script com só 30 letras antes. Medimos o limite, o custo de aumentá-lo e como escrever o regex que não cai nele.

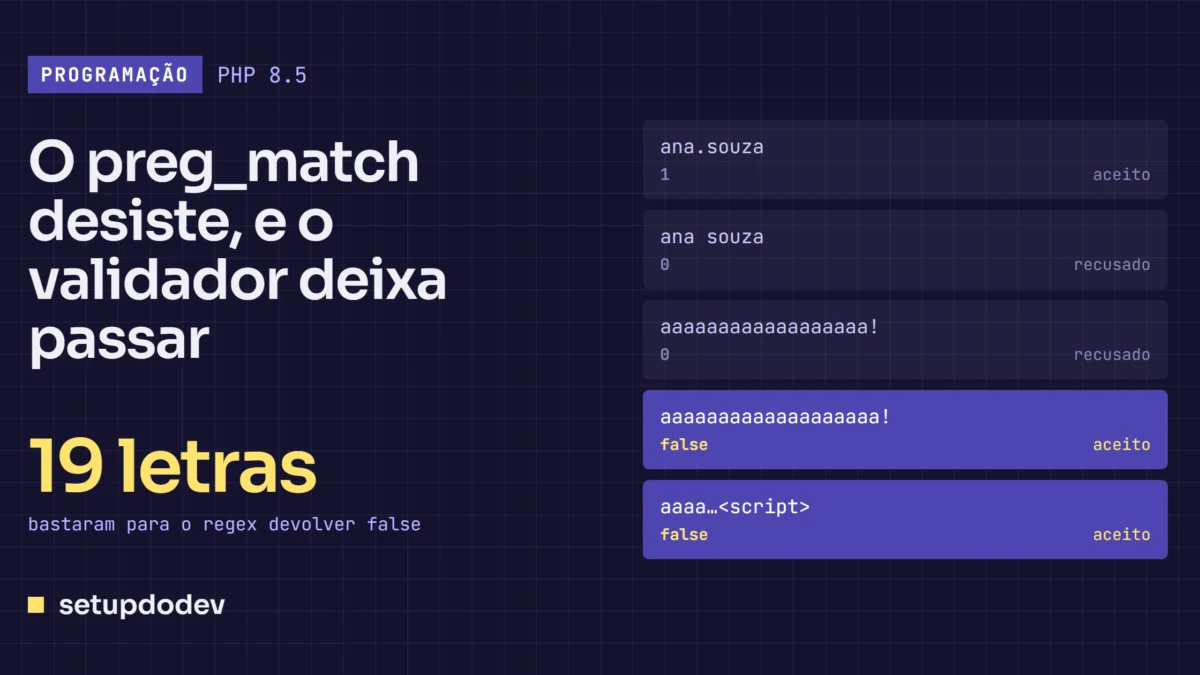
Este validador de nome de usuário recusa ana souza e <script>, como deveria. Mas, com 30 letras antes da tag, ele aceitou aaaaaaaaaaaaaaaaaaaaaaaaaaaaaa<script>alert(1)</script>. Nada travou e nenhum aviso apareceu: o preg_match desistiu em pouco mais de 1 milissegundo e devolveu false, que o código não esperava.
$re = '/^([a-zA-Z0-9]+[._-]?)+$/';

if (preg_match($re, $usuario) === 0) {
    recusar();
}
// false não é 0: o usuário passa
Rodamos tudo aqui no PHP 8.5.7, com PCRE 10.44, no Windows, sem mudar nenhum limite.
Por que volta false
Os dois + aninhados dão ao motor um número enorme de jeitos de dividir a mesma sequência de letras. Quando a linha termina num caractere que não casa, ele tenta todos antes de responder “não”. O PHP corta essa conta no pcre.backtrack_limit, que aqui vale 1.000.000, e o manual documenta o retorno: 1 se casou, 0 se não casou, false se falhou.
Com esse validador, a virada veio cedo. Testando a letra a repetida mais um !, 18 letras deram 0, a resposta certa. Com 19, já veio false, e a mensagem de preg_last_error_msg() foi Backtrack limit exhausted.
O limite cumpre o que promete, porque protege o processador. O problema é o que sobra depois dele: quem não olha o false toma a falha por resposta. Escrito como if (!preg_match(...)), o validador acima recusaria a entrada, porque false também é falso. A armadilha está no === 0.
O filtro que para de filtrar em 1 MB
Na lista de proibidos, a lógica se inverte: casar é o que bloqueia, então false libera. Montamos um filtro bem comum, com .*?, sem nenhum + aninhado para desconfiar:
$filtro = '/<script.*?>.*?<\/script>/is';

if (preg_match($filtro, $texto)) {
    bloquear();
}
Com uma tag cheia de x, ele bloqueou até 999.998 caracteres no recheio. Com 999.999, veio false e o texto passou. São 1.000.016 bytes, e o php.ini de produção que vem com o PHP aceita formulários de até 8 MB. A desistência levou cerca de 0,5 milissegundo.
O preg_replace falha de outro jeito: devolve null. Passamos um HTML por um /<p>(.*?)<\/p>/s. Com 992.007 bytes, saiu certo. Com 1.008.007, saiu null, e um código que grava o resultado sem conferir troca o artigo inteiro por um texto vazio.
O acento também derruba
Nada disso precisa de atacante. Com o modificador /u, o PCRE exige UTF-8 válido, e um arquivo em ISO-8859-1, o que ainda sai de muito sistema antigo por aqui, não é:
$nome = "Jo\xE3o";   // João em ISO-8859-1

preg_match('/^\p{L}+$/u', $nome);        // false
preg_replace('/\s+/u', ' ', $nome);      // null
preg_split('/,/u', $nome);               // false
preg_last_error_msg();
// Malformed UTF-8 characters, possibly incorrectly encoded
A saída é conferir e converter na entrada, e funcionou: mb_check_encoding($nome, 'UTF-8') deu false, e depois de mb_convert_encoding($nome, 'UTF-8', 'ISO-8859-1') o mesmo regex devolveu 1.
O JIT, ligado por padrão, tem o seu próprio limite. O inocente /^(a|b)*$/ funcionou com 6.143 caracteres e, com 6.144, deu JIT stack limit exhausted. Sem JIT, passou com 20 mil e caiu com 200 mil, agora com Recursion limit exhausted. É uma entrada de 6 KB, tamanho comum num corpo de texto.
Aumentar o limite troca um problema por outro
A primeira ideia costuma ser subir o pcre.backtrack_limit. Para /^(a+)+$/ com 30 letras e um !, cada processo rodando sozinho, o resultado continuou false em todos os valores. Só o tempo mudou, e na mesma proporção do limite:
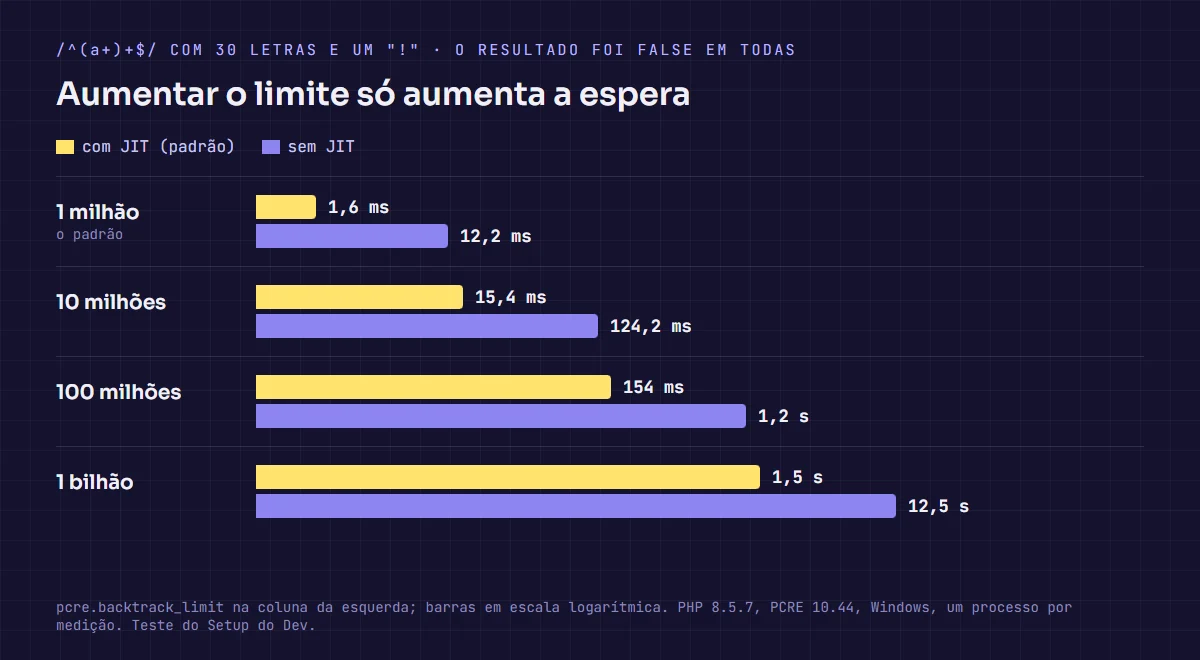
Com o limite em 1 bilhão e sem JIT, uma única requisição ocupa o processo por 12,5 segundos. Era esse o ataque que o limite evitava.
Como escrever para não cair nisso
Tire a ambiguidade do regex. Quantificadores possessivos (++, *+) e grupos atômicos não devolvem o que pegaram, e o motor não tem o que repetir. As trocas abaixo responderam certo nas entradas que derrubavam as originais. A do validador nós comparamos com a primeira versão em todas as 299.593 combinações de até seis caracteres de um alfabeto de teste, e nenhuma resposta mudou:
// validador: mesmas regras, e 100 mil letras com "!" dão 0 em 0,08 ms
'/^[a-zA-Z0-9]++(?:[._-][a-zA-Z0-9]++)*+[._-]?$/'

// /^(a+)+$/  →  100 mil letras com "!" dão 0 em 0,07 ms
'/^a++$/'

// o filtro: achou a tag com 2 MB de recheio, em 0,6 ms
'/<script[^>]*+>(?:[^<]++|<(?!\/script>))*+<\/script>/is'

// /^(a|b)*$/  →  2 MB sem erro
'/^[ab]*+$/'
Não deixe o false passar calado. Um ajudante pequeno resolve, e transforma a falha numa exceção que aparece no log:
function casa(string $re, string $texto): bool
{
    $r = preg_match($re, $texto);
    if ($r === false) {
        throw new RuntimeException('Regex falhou: ' . preg_last_error_msg());
    }
    return $r === 1;
}
Nos filtros, a falha precisa recusar: se o regex não respondeu, a entrada não foi conferida. E limite o tamanho antes de chegar ao regex, porque um campo de nome de usuário não tem motivo para receber 1 MB. E regex não é filtro de HTML: o exemplo do <script> serve para medir a falha, e a proteção de verdade é escapar na saída.
Não dá para saber de olho qual regex cai. Um validador de e-mail parecido, com grupos aninhados, respondeu 0 sem erro nos três tamanhos que testamos, até 100 mil caracteres, e não investigamos o porquê. A prova é rodar o seu com uma entrada longa que quase casa, e olhar se volta false.
Fontes: Manual do PHP: preg_match, Manual do PHP: configuração do PCRE, php.ini-production do PHP 8.5
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário