

Como ler um CSV de 1 milhão de linhas no PHP sem estourar a memória
No nosso teste, o file() precisou de 492 MB para um arquivo de 42 MB e parou no limite padrão de 128 MB. Lendo linha a linha, o pico ficou em 2 MB.

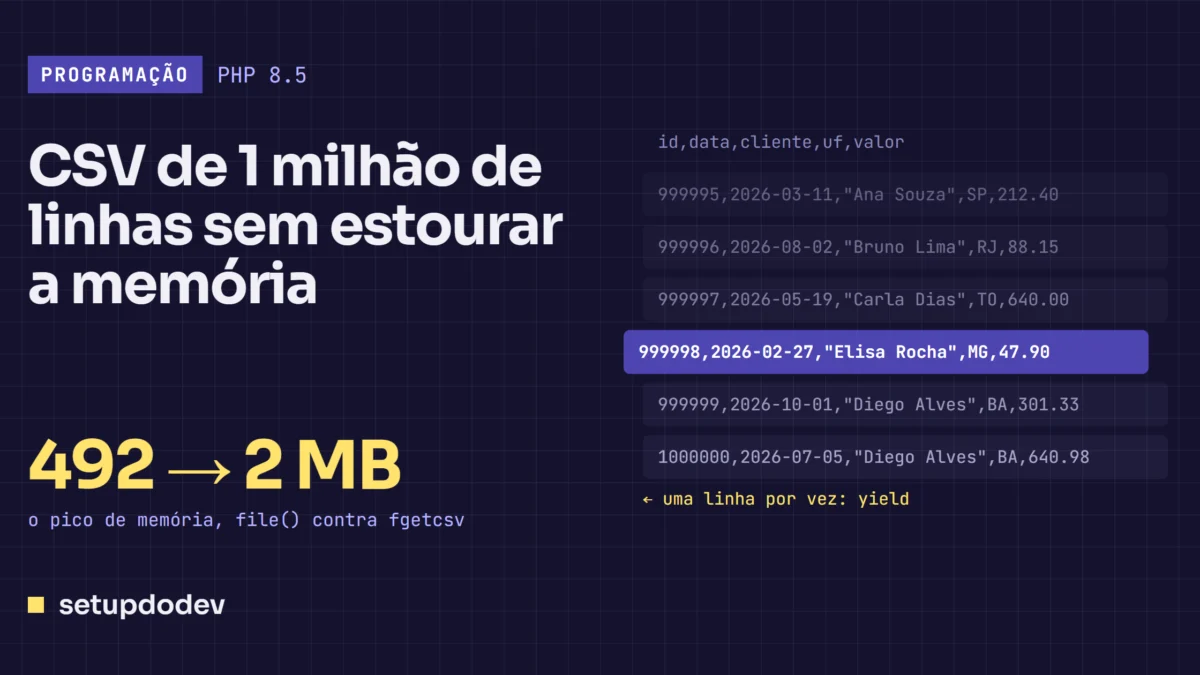
Foi esta a resposta do PHP quando mandamos ler um CSV de pedidos com o jeito mais curto, o file():
PHP Fatal error:  Allowed memory size of 134217728 bytes exhausted
(tried to allocate 4096 bytes) in teste-csv.php on line 46
O arquivo tinha 42 MB, e o limite padrão do PHP é de 128 MB. A conta parece fechar, mas o PHP não guarda um CSV do jeito que ele está no disco: cada linha vira um array, cada campo vira um valor com a estrutura interna do PHP em volta, e a soma passa de dez vezes o tamanho do arquivo. Este guia mede quatro jeitos de ler o mesmo CSV e mostra por que três deles cabem em 2 MB.
O teste
Um CSV de pedidos com 1 milhão de linhas e 42 MB, gerado com fputcsv, com cinco colunas: id, data, cliente, UF e valor. Alguns nomes têm vírgula e aspas, como acontece em cadastro de verdade ("Fábio ""Fabinho"" Reis"). A tarefa é somar o valor por UF. Cada jeito de ler rodou três vezes, num processo PHP separado, no PHP 8.5.7 de uma máquina Windows, e todos chegaram à mesma soma para São Paulo, R$ 50.305.665,68.
Por que o file() pesa tanto
O caminho mais curto é carregar tudo e depois percorrer:
$linhas = array_map(
    fn ($l) => str_getcsv($l, ',', '"', ''),
    file('pedidos.csv', FILE_IGNORE_NEW_LINES)
);
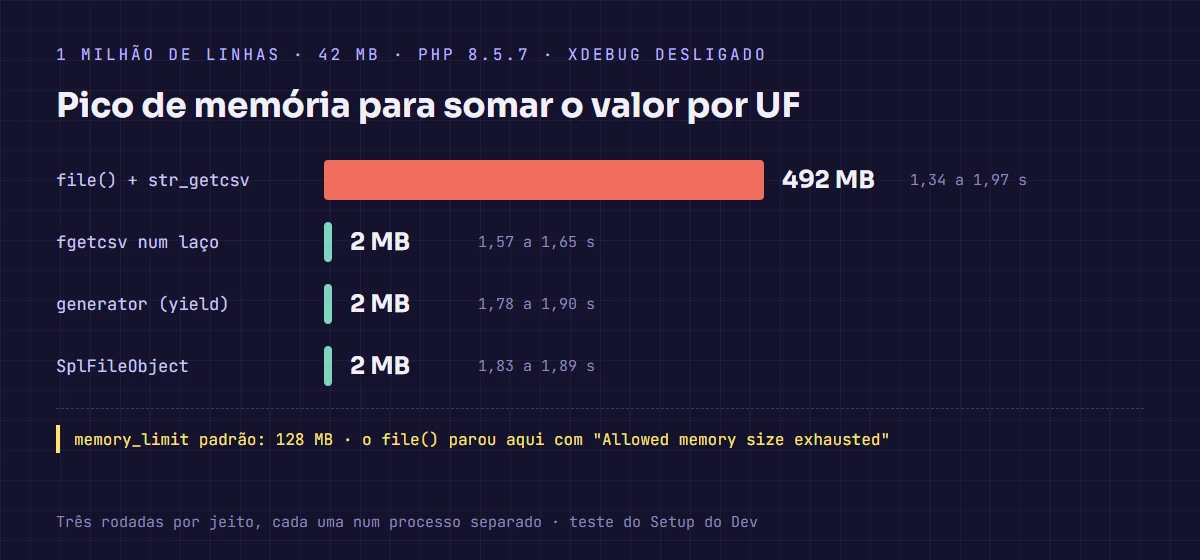
Com o limite padrão de 128 MB, foi aqui que o script morreu. Com o limite liberado (-d memory_limit=-1), ele terminou, mas o pico de memória foi de 492 MB, 11,7 vezes o tamanho do arquivo. O file() cria um array com 1 milhão de strings, e o array_map cria outro com 1 milhão de arrays de cinco posições. No servidor, isso multiplica pelo número de processos rodando ao mesmo tempo.
fgetcsv: uma linha por vez
O fgetcsv lê do arquivo aberto só a próxima linha e já devolve os campos separados. A memória usada não depende do tamanho do arquivo:
$h = fopen('pedidos.csv', 'r');
fgetcsv($h, null, ',', '"', '');          // pula o cabeçalho
$soma = [];
while (($l = fgetcsv($h, null, ',', '"', '')) !== false) {
    $soma[$l[3]] = ($soma[$l[3]] ?? 0) + (float) $l[4];
}
fclose($h);
Pico de 2 MB e o menor tempo do teste, entre 1,57 e 1,65 segundo. O que fica na memória é o array $soma, com dez UFs.
Um generator para reaproveitar a leitura
O laço acima mistura duas coisas, ler o arquivo e fazer a conta. Quando a leitura se repete em vários lugares, um generator separa as duas sem perder a economia: a função entrega uma linha de cada vez com yield, e quem chama usa um foreach comum.
function lerCsv(string $arquivo): Generator
{
    $h = fopen($arquivo, 'r');
    try {
        $cab = fgetcsv($h, null, ',', '"', '');
        while (($linha = fgetcsv($h, null, ',', '"', '')) !== false) {
            yield array_combine($cab, $linha);
        }
    } finally {
        fclose($h);
    }
}

foreach (lerCsv('pedidos.csv') as $p) {
    $soma[$p['uf']] = ($soma[$p['uf']] ?? 0) + (float) $p['valor'];
}
De brinde, as colunas ganham nome ($p['uf'] em vez de $l[3]), e o finally fecha o arquivo mesmo se o foreach parar no meio com um break. O pico continuou em 2 MB. O tempo subiu para cerca de 1,8 segundo, o preço do array_combine e da chamada a mais por linha.
Com o SplFileObject dá para chegar no mesmo lugar sem escrever a função. As flags certas são READ_CSV, READ_AHEAD e SKIP_EMPTY. Só com a primeira, o teste contou 1.000.002 linhas em vez de 1.000.001, e a última era [null]: a quebra de linha do fim do arquivo vira uma linha vazia. Pico de 2 MB e 1,86 segundo.
Duas pegadinhas que apareceram no caminho
A primeira é do PHP 8.4 em diante. Chamar o fgetcsv sem o quinto argumento, o caractere de escape, gera um aviso:
PHP Deprecated:  fgetcsv(): the $escape parameter must be provided
as its default value will change
Por isso todos os exemplos passam '' no fim. O escape com barra invertida não faz parte do formato CSV, e a string vazia deixa as aspas duplas como o único jeito de escapar, que é o que planilhas e bancos de dados geram.
A segunda custou uma rodada inteira do teste. A primeira medição deu o generator levando de 5 a 8 segundos, quatro vezes mais que o fgetcsv. O motivo era o Xdebug carregado no PHP da máquina, que pesa em cada chamada de função, e um generator faz uma chamada por linha. Com -d xdebug.mode=off, os quatro jeitos ficaram entre 1,6 e 1,9 segundo. Se um script de importação está lento no servidor, confira o php -v: a linha “with Xdebug” não deveria estar lá em produção.
O resultado
| Jeito de ler | Pico de memória | Tempo (3 rodadas) |
|---|---|---|
file() + str_getcsv | 492 MB | 1,34 a 1,97 s |
fgetcsv num laço | 2 MB | 1,57 a 1,65 s |
generator com fgetcsv | 2 MB | 1,78 a 1,90 s |
SplFileObject | 2 MB | 1,83 a 1,89 s |
A recomendação do Setup do Dev: para arquivo que vem de fora, de tamanho que você não controla, comece pelo generator. A diferença de tempo é pequena, a memória não cresce com o número de linhas, porque só uma fica aberta de cada vez, e a leitura fica num lugar só. O file() continua bom para o arquivo de configuração de 50 linhas, e é para isso que ele deve ficar.
Quem está atualizando o projeto para as versões novas da linguagem encontra as outras mudanças no guia do PHP 8.5.
Fontes: Manual do PHP: fgetcsv, Manual do PHP: generators, Manual do PHP: SplFileObject, Documentação do Xdebug: xdebug.mode
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário