

Paginação lenta no PostgreSQL: medimos o OFFSET num milhão de linhas e trocamos por keyset
A página perto do fim levou 0,8 s com OFFSET e 0,2 ms com keyset. E os dois detalhes que fazem uma listagem pular ou repetir linhas entre as páginas.

Toda listagem começa igual: ORDER BY criado_em DESC LIMIT 20 OFFSET .... A primeira página é instantânea, e ninguém repara que a última não é. Medimos no PostgreSQL 18.4, numa tabela de um milhão de pedidos, e depois trocamos o OFFSET pela paginação por chave, o keyset.
A tabela do teste
Uma tabela temporária com um milhão de linhas, 65 MB, e a data de cada pedido sorteada em 300 dias, com segundos. O sorteio deixou 980.650 instantes diferentes, o que quer dizer que há pedidos com a mesma data e hora, e isso vai importar mais adiante. O índice segue a ordem da listagem:
CREATE TEMPORARY TABLE pedidos (
  id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  criado_em timestamptz NOT NULL,
  cliente text NOT NULL,
  valor numeric(10,2) NOT NULL
);
-- (1 milhão de linhas com generate_series)
CREATE INDEX ON pedidos (criado_em DESC, id DESC);
ANALYZE pedidos;
O ANALYZE é obrigatório aqui. A documentação do CREATE TABLE lembra que o autovacuum não enxerga tabela temporária, e sem estatística o planejador escolhe às cegas.
A primeira rodada também ensinou uma coisa sobre tabela temporária. Ela não usa o cache comum do banco, e sim o temp_buffers, que aqui estava em 8 MB. Com a tabela inteira saindo do disco a cada consulta, o OFFSET 990000 levou 26 segundos. Subimos para 256 MB com SET temp_buffers = '256MB' antes de criar a tabela, e os números abaixo são dessa segunda rodada, com os dados em memória, como num banco de produção bem dimensionado.
O OFFSET lê tudo o que pula
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, criado_em, cliente, valor FROM pedidos
ORDER BY criado_em DESC, id DESC OFFSET 990000 LIMIT 20;

Limit (actual rows=20.00 loops=1)
  -> Index Scan using pedidos_criado_em_id_idx on pedidos
       (actual rows=990020.00 loops=1)
       Buffers: local hit=993690
Execution Time: 774.347 ms
O plano diz tudo: para devolver 20 linhas, o índice entregou 990.020, e o banco descartou as 990 mil primeiras. A documentação do LIMIT é direta: as linhas puladas pelo OFFSET ainda precisam ser calculadas dentro do servidor. O custo cresce em linha reta com o número da página:
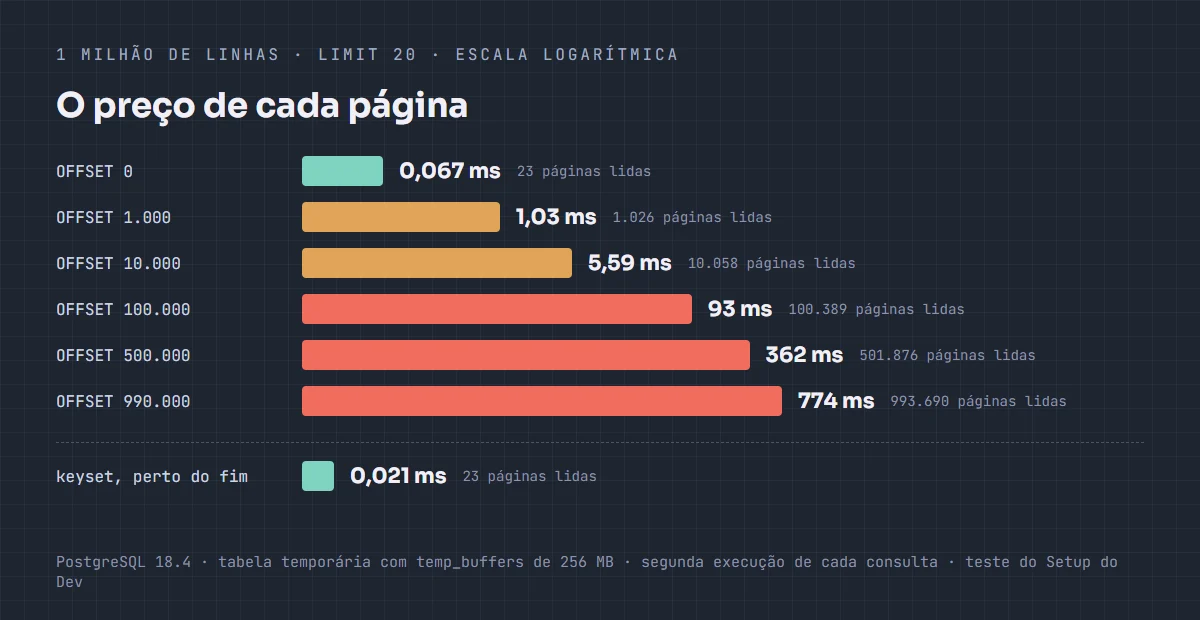
De 0,07 ms na primeira página a 774 ms perto da última, com o número de páginas de dados lidas acompanhando o OFFSET quase um por um. Numa API pública, é a rota que um robô percorre até o fim e que segura uma conexão do banco por quase um segundo a cada pedido.
Keyset: começar de onde a página anterior parou
Em vez de dizer quantas linhas pular, a consulta diz depois de qual linha começar. A aplicação guarda a data e o id da última linha mostrada e manda os dois na próxima chamada:
SELECT id, criado_em, cliente, valor FROM pedidos
WHERE (criado_em, id) < ('2026-01-04 00:37:02-03', 221941)
ORDER BY criado_em DESC, id DESC
LIMIT 20;
A mesma página do fim veio em 0,021 ms, lendo 23 páginas de dados, e conferimos que as 20 linhas eram as mesmas do OFFSET 990000. No plano, a comparação aparece como Index Cond: o índice vai direto ao ponto, e o tempo não depende de quantas páginas vieram antes.
A comparação (criado_em, id) < (...) é de linhas inteiras. A documentação explica que os elementos são comparados da esquerda para a direita, parando no primeiro par diferente. É o que faz a ordem por data, e o id só desempatar, sem precisar escrever criado_em < x OR (criado_em = x AND id < y).
Por que o id entra na chave
Paginar só pela data parece suficiente até aparecerem dois pedidos no mesmo segundo. Montamos seis pedidos, três deles às 10h01, e paginamos de dois em dois usando só a data: a primeira página trouxe os pedidos 6 e 5; a segunda, com criado_em < '10:02', trouxe 4 e 3; a terceira, com criado_em < '10:01', pulou direto para o pedido 1. O pedido 2, também das 10h01, sumiu da listagem. Com (criado_em, id), a terceira página trouxe 2 e 1.
A documentação do LIMIT pede a mesma coisa por outro motivo: sem um ORDER BY que dê uma ordem única, cada página é um subconjunto imprevisível. Uma coluna única no fim da ordenação resolve as duas coisas.
O OFFSET também repete linhas
Com a tabela grande, pegamos a primeira página de cinco pedidos, que terminava no 81894. Inserimos um pedido novo e pedimos a segunda página com OFFSET 5: ela começou pelo 81894 de novo. O pedido novo empurrou todo mundo uma posição para baixo, e quem rola um feed vê o mesmo item duas vezes. O keyset não tem esse problema, porque a segunda página começa depois da última linha vista, e não numa posição contada.
O que o keyset não faz
Ele não pula para a página 37, porque não existe “página 37”, só “depois desta linha”. Também não diz quantas páginas há, e um count(*) na tabela inteira tem o custo dele. Funciona bem para “carregar mais”, rolagem infinita e APIs com cursor; numa tela administrativa com números de página e poucos milhares de linhas, o OFFSET continua bom. A ordem mista também complica: com ORDER BY criado_em DESC, id ASC, a comparação de linhas não serve, porque ela compara as duas colunas no mesmo sentido.
Se a sua listagem passa de algumas centenas de páginas, troque. A consulta muda pouco, o índice é o mesmo, e a última página passa a custar o mesmo que a primeira.
Fontes: Documentação do PostgreSQL: LIMIT e OFFSET, Documentação do PostgreSQL: comparação de linhas, Documentação do PostgreSQL: CREATE TABLE
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário