

Índice GIN em JSONB no PostgreSQL, testado em 1 milhão de linhas
O índice levou a busca por cliente de 400 ms para 0,2 ms, mas deixou a da chave mais comum mais lenta, e não ajudou em nenhuma comparação com maior que.

Uma coluna jsonb com um índice GIN parece resolver qualquer busca dentro do JSON. No nosso teste, com 1 milhão de eventos no PostgreSQL 18.4, ela resolveu algumas muito bem, levando a busca por um cliente de 400 ms para 0,2 ms, e não resolveu outras: o operador ->>, a comparação com “maior que” e a chave que aparece em metade das linhas. Este guia mostra os dois tipos de índice GIN, o B-tree numa expressão, e o que cada um aceita.
A tabela do teste
Criamos uma tabela TEMPORARY, que some quando a sessão fecha, com um milhão de eventos parecidos com os de uma loja:
{"tags": ["promo", "app"], "tipo": "reembolso", "cupom": "BLACK30",
 "valor": 370.00, "cliente_id": 19001}
A distribuição era desigual de propósito: 560 mil visitas, 280 mil cadastros, 140 mil carrinhos, 18 mil pagamentos e 2 mil reembolsos; 50 mil clientes, 20 eventos para cada; e só mil eventos com cupom. A tabela ficou com 130 MB.
Um detalhe antes de medir: tabela temporária não passa pelo autovacuum, e a documentação do CREATE TABLE recomenda rodar o ANALYZE à mão. Antes dele, o pg_class dizia que a tabela tinha -1 linhas, ou seja, que nunca tinha sido analisada, e o planejador escolheria às cegas.
Sem índice e com o GIN padrão
Sem índice, buscar os eventos do cliente 4242 lê a tabela inteira:
SELECT count(*) FROM eventos WHERE dados @> '{"cliente_id": 4242}';
-- Seq Scan: de 385 a 569 ms, 999.980 linhas descartadas
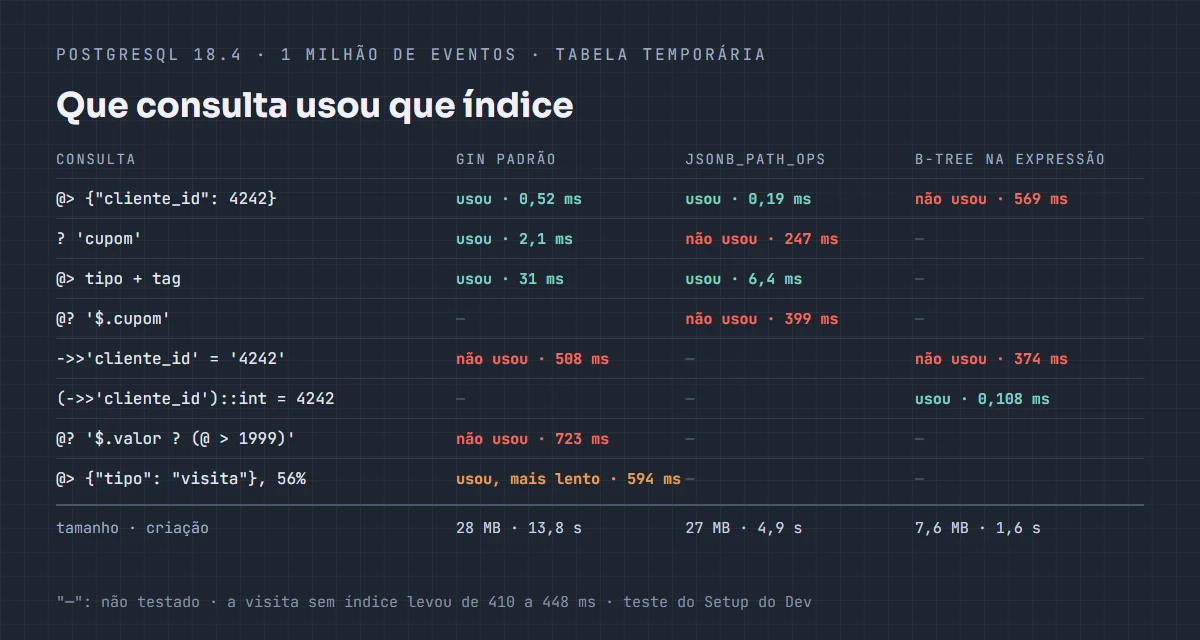
O GIN padrão (jsonb_ops) indexa cada chave e cada valor do documento. Ele levou 13,8 segundos para ser criado, ficou com 28 MB, e a mesma busca caiu para 0,52 ms. Ele também atendeu o ?, que pergunta se a chave existe (dados ? 'cupom', 2 ms para os mil eventos), e a busca combinada por tipo e tag.
CREATE INDEX eventos_gin ON eventos USING gin (dados);O que o GIN não atende
Com o índice criado, três consultas continuaram lendo a tabela inteira ou ficaram mais lentas.
O ->>. WHERE dados->>'cliente_id' = '4242' traz o mesmo resultado que o @>, mas não usa o GIN, que só conhece os operadores de JSON. Foram 508 ms, contra 0,52 ms.
A comparação de valor. O @> só testa igualdade. Para “valor maior que 1999”, o jsonpath parece a saída, e o GIN aceita o operador @?. Mas a documentação do tipo JSON explica que o índice só aproveita as partes do caminho com == constante. A consulta dados @? '$.valor ? (@ > 1999)' leu a tabela inteira, 723 ms, com o índice ali do lado.
A chave comum. Buscar {"tipo": "visita"}, que está em 56% das linhas, usou o índice e levou de 594 a 599 ms. Desligando o índice para essa consulta, a leitura direta levou de 410 a 448 ms. O planejador estimou 545 mil linhas, perto das 560 mil reais, e ainda assim escolheu o caminho mais lento. Índice ajuda a achar poucas linhas; para metade da tabela, ele só soma trabalho.
O jsonb_path_ops
O segundo tipo de GIN indexa o caminho inteiro até cada valor, em vez de chaves e valores soltos. A documentação diz que ele costuma ser “muito menor” e mais rápido no @>, em troca de não atender o operador ?.
CREATE INDEX eventos_gin_path ON eventos USING gin (dados jsonb_path_ops);No teste, a criação levou 4,9 segundos, quase três vezes menos que o padrão, mas o tamanho quase não mudou: 27 MB contra 28 MB. Os nossos documentos têm poucas chaves e valores bem variados, e é aí que a vantagem de tamanho some. A busca ficou mais rápida: 0,19 ms para o cliente e 6,4 ms para tipo e tag juntos, contra 31 ms no padrão, porque o índice leu 40 páginas em vez de 574.
A troca apareceu como a documentação avisa. A busca do cupom com ? voltou a ler a tabela toda (247 ms), e escrever a mesma pergunta como jsonpath, dados @? '$.cupom', também não usou o índice (399 ms).
Quando a busca é sempre pela mesma chave
Se o sistema busca quase sempre pelo cliente, um B-tree na expressão resolve com um índice bem menor:
CREATE INDEX eventos_cliente ON eventos (((dados->>'cliente_id')::int));

SELECT count(*) FROM eventos WHERE (dados->>'cliente_id')::int = 4242;
-- 0,108 ms
Foram 7,6 MB, um quarto do GIN, criados em 1,6 segundo. Mas a consulta precisa repetir a expressão do índice, como a documentação de índices em expressões explica. Sem o ::int (dados->>'cliente_id' = '4242'), o planejador não reconheceu o índice e voltou a ler a tabela: 374 ms. E o @> também não usa esse índice.
Qual escolher
Se as buscas variam e às vezes perguntam se uma chave existe, use o GIN padrão. Se são quase todas de contenção (@>) com vários campos, o jsonb_path_ops é mais rápido e mais barato de criar. Se uma ou duas chaves concentram as buscas, B-tree na expressão, escrita igual na consulta. E a chave que você filtra por intervalo, como o valor ou a data, merece sair do JSON e virar coluna de verdade: nenhum dos dois GIN ajudou com o “maior que”.
Fontes: Documentação do PostgreSQL: JSON, Documentação do PostgreSQL: índices em expressões, Documentação do PostgreSQL: CREATE TABLE
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário