

COUNT(*) no PostgreSQL: medimos a contagem exata, a estimativa e o contador por gatilho
Em 1 milhão de linhas na memória, o COUNT(*) levou 29 ms; em 5 milhões fora dela, 1,5 s. O contador por gatilho deixou as inserções 150 vezes mais lentas.

A tela de administração mostra “1.234.567 pedidos” no topo, e a página demora. O culpado costuma ser o SELECT count(*) que monta esse número a cada visita. Medimos no PostgreSQL 18.4 quanto ele custa, e as duas alternativas que aparecem em toda discussão: a estimativa das estatísticas e o contador mantido por gatilho.
O resumo antes dos números: a contagem exata é rápida enquanto a tabela cabe na memória e salta quando não cabe; a estimativa é instantânea e erra até o próximo ANALYZE; o contador por gatilho é exato e cobra caro de cada inserção.
Por que contar é ler tudo
A wiki do PostgreSQL explica: por causa do MVCC, cada transação pode enxergar um estado diferente da tabela, e o banco não guarda um total que sirva para todas. Para contar, ele precisa visitar cada linha e conferir se ela é visível para quem pergunta. Em geral, isso é uma leitura sequencial da tabela inteira.
A contagem exata, em dois tamanhos
Criamos uma tabela TEMPORARY de pedidos com 1 milhão de linhas (86 MB) e rodamos EXPLAIN (ANALYZE) no count(*):
SELECT count(*) FROM pedidos;
-- Seq Scan on pedidos (rows=1000000)
-- Buffers: local hit=11021
-- Execution Time: 29.874 ms
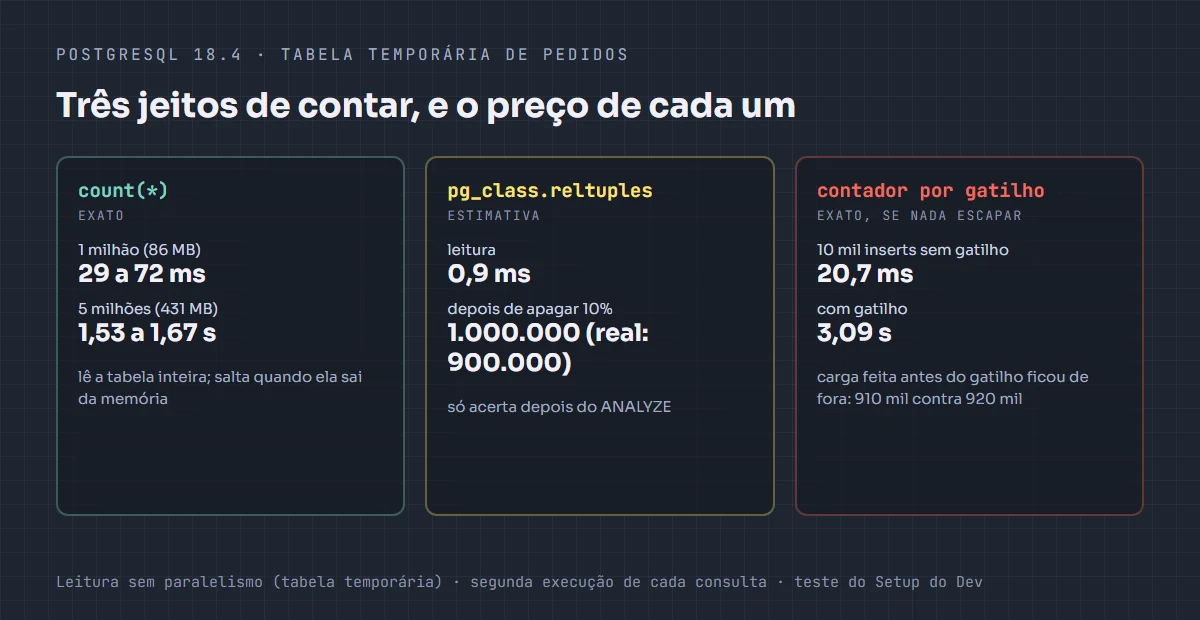
Foram de 29 a 72 ms nas várias rodadas, sempre lendo as 11.021 páginas da tabela. Com tudo na memória, não é lento. Repetimos com 5 milhões de linhas, 431 MB, numa sessão com 256 MB de memória para tabelas temporárias: a mesma consulta levou de 1,53 a 1,67 s. Cinco vezes mais linhas custaram cerca de 50 vezes mais tempo, porque a tabela deixou de caber na memória.
Um aviso sobre o teste: tabela temporária não usa leitura em paralelo, e uma tabela comum, com vários núcleos, conta mais rápido. A proporção, porém, é a mesma: o tempo cresce com o tamanho, e salta quando a tabela sai da memória.
Também testamos o mito do count(1): deu o mesmo tempo do count(*), dentro da variação entre rodadas. Já o count(obs) conta outra coisa, só as linhas em que a coluna não é nula: 750 mil, contra 1 milhão do count(*).
A estimativa, em menos de 1 ms
O PostgreSQL guarda uma estimativa do número de linhas no catálogo, a mesma que o planejador usa. A página da wiki sobre estimativas mostra o caminho:
SELECT reltuples::bigint AS estimativa
FROM pg_class WHERE oid = 'pedidos'::regclass;
-- 1000000, em 0,9 ms
O preço é a defasagem. Logo depois de criada, a tabela tinha reltuples = -1, ou seja, nunca analisada. Tabela temporária não passa pelo autovacuum, e a documentação do CREATE TABLE pede que o ANALYZE seja rodado à mão. Depois do VACUUM ANALYZE, a estimativa bateu: 1.000.000. Então apagamos os 10% de pedidos cancelados. A estimativa continuou dizendo 1.000.000, com 900.000 linhas reais, até o ANALYZE seguinte. Numa tabela comum, o autovacuum corrige isso sozinho, mas não na hora.
Para uma contagem com filtro, o próprio EXPLAIN dá uma estimativa: para status = 'pago', ele previu 300.960 linhas, e o número real era 300.000.
O contador por gatilho, e quanto ele cobra
A terceira saída é manter o total numa tabela à parte, atualizada por um gatilho a cada inserção e exclusão:
CREATE FUNCTION conta() RETURNS trigger LANGUAGE plpgsql AS $$
BEGIN
  IF TG_OP = 'INSERT' THEN UPDATE contagem SET n = n + 1 WHERE tabela = 'pedidos';
  ELSE UPDATE contagem SET n = n - 1 WHERE tabela = 'pedidos'; END IF;
  RETURN NULL;
END $$;
CREATE TRIGGER t_conta AFTER INSERT OR DELETE ON pedidos
  FOR EACH ROW EXECUTE FUNCTION conta();
A leitura do total fica instantânea e exata. A escrita é que paga: inserir 10 mil pedidos levou 20,7 ms sem o gatilho e 3,09 s com ele, cerca de 150 vezes mais. Cada linha inserida atualiza a mesma linha de contagem, e com várias sessões inserindo ao mesmo tempo elas passam a esperar umas pelas outras nessa linha.
O teste ainda mostrou o outro risco. Inserimos 10 mil pedidos antes de criar o gatilho, e o contador terminou com 910 mil, contra 920 mil reais. Tudo que entra por um caminho que o gatilho não vê fica de fora: carga feita antes dele, gatilho desligado durante uma importação. O TRUNCATE também não dispara gatilhos de linha.
Qual usar
Se a tabela tem até alguns milhões de linhas e o número precisa ser exato, o count(*) resolve, e o primeiro passo é tirá-lo das telas que abrem toda hora. Se a tela só precisa da ordem de grandeza (“cerca de 1,2 milhão de pedidos”), use a estimativa do pg_class. O contador por gatilho vale para tabelas que recebem pouca escrita e muita leitura do total, e pede uma conferência periódica contra o count(*) de verdade.
Fontes: Wiki do PostgreSQL: Slow Counting, Wiki do PostgreSQL: Count estimate, Documentação do PostgreSQL: CREATE TABLE
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário