

Acento quebra strlen, substr e ucfirst no PHP; testamos cada caso e a função que resolve
No PHP 8.5, "ação" tem 6 bytes e 4 letras. Um corte no meio do ç faz o json_encode devolver false, e o htmlspecialchars pode devolver texto vazio.

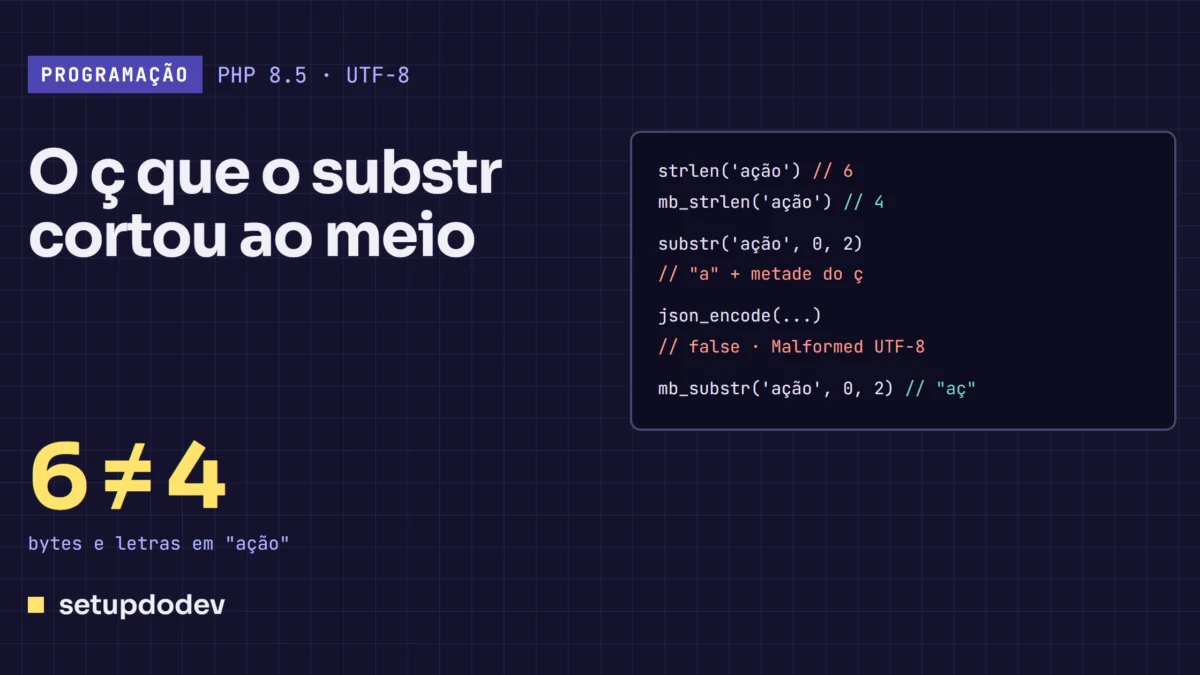
Para o PHP, uma string é uma sequência de bytes. No UTF-8, as letras sem acento ocupam um byte, e “ç”, “ã” e “é” ocupam dois. Por isso “ação” tem 4 letras e 6 bytes, e as funções clássicas de texto (strlen, substr, ucfirst, str_pad) contam e cortam bytes. Em inglês ninguém percebe. Em português, o erro aparece no primeiro nome de cliente com acento.
Testamos cada caso no PHP 8.5.7, com o default_charset em UTF-8, e a troca pela função da extensão mbstring, que conta letras. As saídas abaixo são as do teste.
O tamanho e o corte
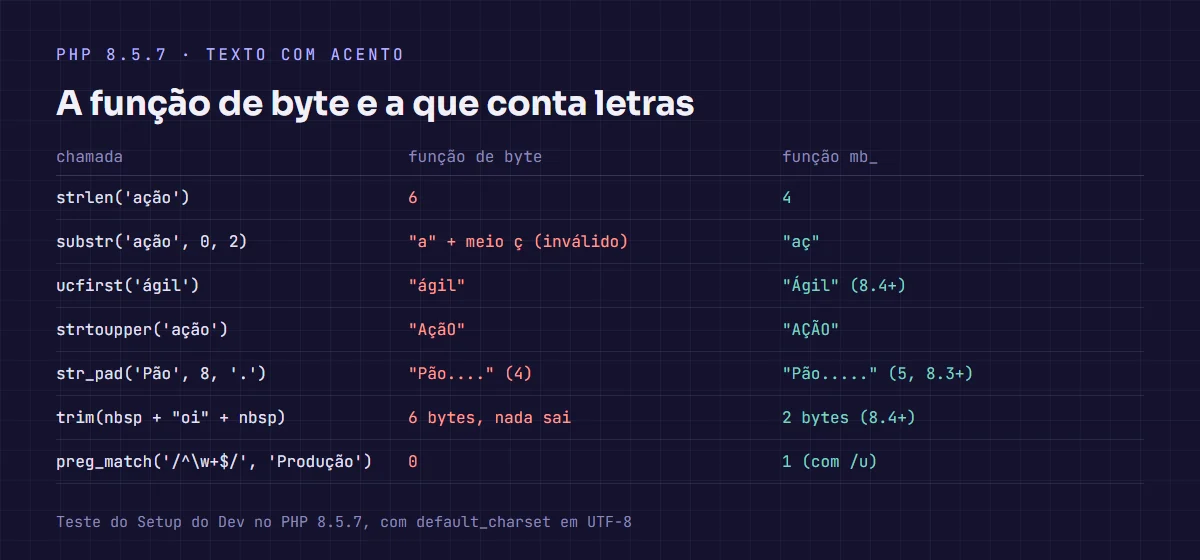
strlen('ação')        // 6
mb_strlen('ação')     // 4
substr('ação', 0, 2)  // "a" + metade do ç (bytes 61 c3)
mb_substr('ação', 0, 2) // "aç"
A validação “no máximo 30 caracteres” feita com strlen recusa antes da hora o nome com acento. O substr é pior, porque corta o “ç” ao meio e deixa uma sequência que não é UTF-8 válido. O problema aparece longe dali:
json_encode(['t' => substr('ação', 0, 2)]);
// false
json_last_error_msg();
// "Malformed UTF-8 characters, possibly incorrectly encoded"

htmlspecialchars(substr('ação', 0, 2), ENT_QUOTES);
// "" (string vazia)
O json_encode devolve false, e a API responde vazio. O htmlspecialchars com só ENT_QUOTES devolve string vazia, comportamento descrito no manual: com sequência inválida, o retorno é vazio, a menos que ENT_SUBSTITUTE ou ENT_IGNORE estejam nos flags. Desde o PHP 8.1, o padrão da função já inclui o ENT_SUBSTITUTE, e sem flags o teste devolveu “a” seguido do caractere de substituição (�). Quem passa os flags à mão, como muito código antigo faz, cai no vazio.
Para resumo com reticências, o mb_strimwidth corta pela largura e acrescenta o final: mb_strimwidth('Configuração avançada', 0, 15, '…') devolveu “Configuração a…”.
Maiúsculas e minúsculas
ucfirst('ágil')        // "ágil" (sem mudança)
mb_ucfirst('ágil')     // "Ágil"  (PHP 8.4+)
strtoupper('ação')     // "AçãO"
mb_strtoupper('ação')  // "AÇÃO"
ucwords('álvaro de ávila')                         // "álvaro De ávila"
mb_convert_case('álvaro de ávila', MB_CASE_TITLE)  // "Álvaro De Ávila"
strcasecmp('ÁGUA', 'água')  // -32 (diferentes)
Desde o PHP 8.2, o manual do strtoupper diz que a conversão não depende mais do setlocale() e só mexe nas letras ASCII. Por isso o “AçãO”: o “a” e o “o” viraram maiúsculas, e as letras com acento ficaram como estavam. O mb_ucfirst e o mb_lcfirst chegaram no PHP 8.4; antes disso, a saída é juntar mb_strtoupper(mb_substr($s, 0, 1)) com o resto.
Duas observações do teste. O MB_CASE_TITLE põe maiúscula em toda palavra, inclusive no “De”: para nome de pessoa, as partículas (de, da, dos) pedem uma regra sua. E para comparar sem diferenciar maiúscula, o strcasecmp não serve com acento; mb_strtolower($a) === mb_strtolower($b) deu verdadeiro no teste.
Alinhar e limpar
str_pad('Pão', 8, '.')     // "Pão...." (4 pontos)
mb_str_pad('Pão', 8, '.')  // "Pão....." (5 pontos, PHP 8.3+)

strlen(trim("\u{00A0}oi\u{00A0}"))     // 6
strlen(mb_trim("\u{00A0}oi\u{00A0}"))  // 2 (PHP 8.4+)
O str_pad conta os 4 bytes de “Pão” e põe um ponto a menos, o que desalinha relatório em texto e arquivo de largura fixa, como os de remessa bancária. O mb_str_pad existe desde o PHP 8.3.
O trim remove espaço, tabulação e quebra de linha, mas não o espaço inquebrável (U+00A0), que vem junto quando alguém cola texto de uma página ou de um documento. No teste, o “oi” continuou com 6 bytes. O mb_trim, do PHP 8.4, remove os espaços do Unicode, e o resultado teve 2.
Expressão regular sem o modificador u
preg_match('/^\w+$/', 'Produção')   // 0
preg_match('/^\w+$/u', 'Produção')  // 1
Sem o u, o PCRE lê bytes, e os dois bytes do “ç” não contam como letra. Com ele, o manual diz que o padrão e o texto são tratados como UTF-8. O mesmo vale para o preg_split('//', ...): sem o u, “pé” saiu em três pedaços, com o “é” partido ao meio. Já falamos de outra armadilha do preg_match, o false do limite de backtracking, que também passa sem aviso.
O caso que nem o mb_ resolve
O “é” pode chegar de dois jeitos: como um caractere só (U+00E9) ou como “e” seguido do acento combinante (U+0301). Na tela, são iguais. Para o PHP, não:
$d = "e\u{0301}";
strlen($d)          // 3
mb_strlen($d)       // 2
grapheme_strlen($d) // 1
$d === 'é'          // false
Normalizer::normalize($d, Normalizer::FORM_C) === 'é'  // true
O mb_strlen conta dois pontos de código, e a busca por “é” não acha o texto decomposto. A saída é normalizar na entrada com o Normalizer da extensão intl, na forma C, antes de gravar ou comparar. Quem precisa contar o que a pessoa vê como uma letra usa o grapheme_strlen, da mesma extensão.
A regra que tiramos do teste
Em texto que vem de usuário, a função de byte só é segura quando a intenção é mesmo contar bytes, como no limite de tamanho de uma coluna em bytes. Para o resto, a troca é direta:
strlen,substr,str_pad,trim→mb_strlen,mb_substr,mb_str_pad,mb_trim;strtoupper,ucfirst,ucwords→mb_strtoupper,mb_ucfirst,mb_convert_case;- expressão regular → sempre com
u; - texto vindo de fora →
Normalizer::normalizeantes de comparar.
E, onde a string vira JSON ou HTML, vale conferir com mb_check_encoding($s, 'UTF-8') antes: foi ele que mostrou, no teste, que o corte do substr já não era UTF-8 válido.
Fontes: Manual do PHP: mbstring, Manual do PHP: htmlspecialchars, Manual do PHP: strtoupper, Manual do PHP: modificadores do PCRE
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário