

Relatório por dia no PostgreSQL sem sumir com os dias em que não houve venda
O GROUP BY por data esconde os dias vazios, e o gráfico pula do dia 3 para o 5. Testamos o generate_series, o LEFT JOIN e o fuso que muda o dia da venda.

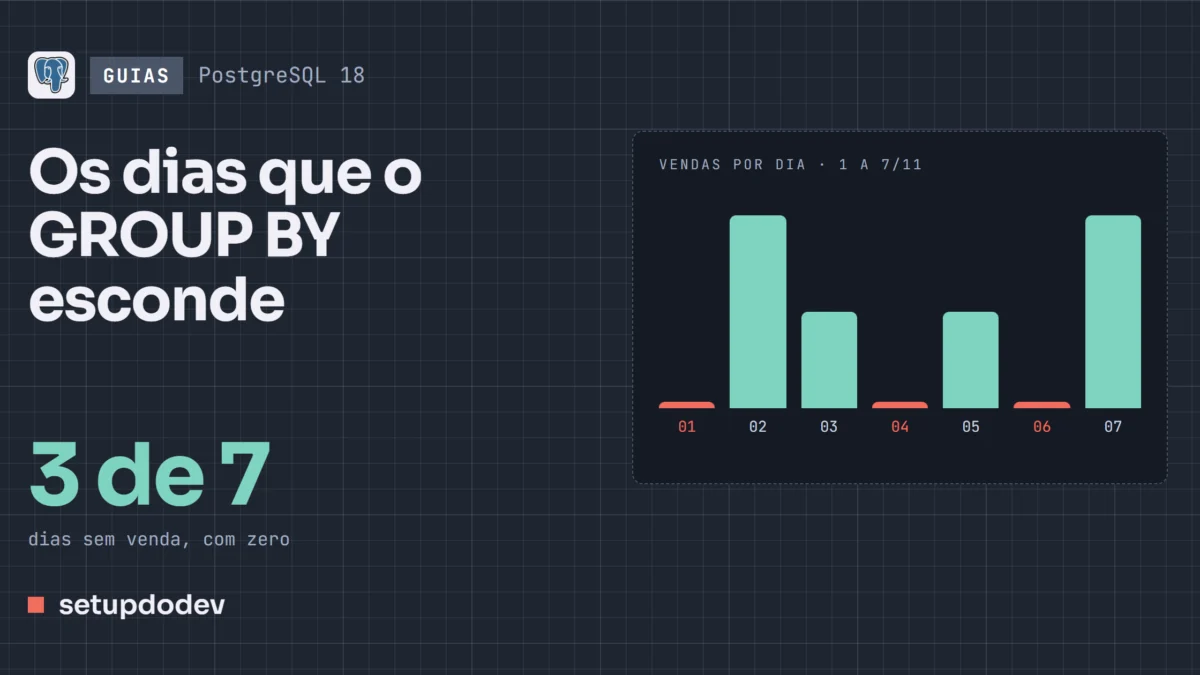
O relatório de vendas por dia mostra os dias 2, 3, 5 e 7 de novembro. Os dias 1, 4 e 6 não aparecem, porque neles não houve venda, e um GROUP BY só agrupa o que existe. No gráfico, as barras ficam encostadas, e quem olha não percebe que o dia 4 foi zero.
Montamos o caso com uma tabela temporária no PostgreSQL 18.4, com seis vendas entre 2 e 7 de novembro, e testamos o jeito de fazer todos os dias aparecerem, com as duas armadilhas que surgem no caminho.
O relatório que esconde os dias
SELECT criada_em::date AS dia, count(*) AS vendas, sum(valor) AS total
FROM venda
WHERE criada_em >= '2026-11-01' AND criada_em < '2026-11-08'
GROUP BY 1 ORDER BY 1;
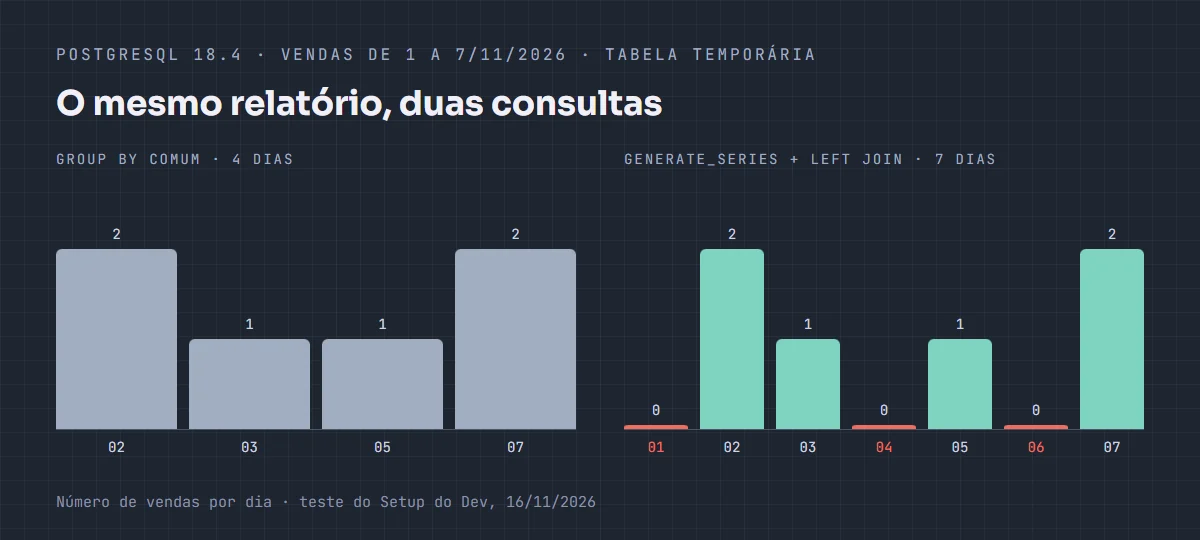
Saíram quatro linhas: 2 de novembro com duas vendas, 3 com uma, 5 com uma e 7 com duas. Para o banco, não há o que agrupar nos outros dias, e ele está certo. Quem precisa da lista de dias é o relatório.
Uma linha por dia, venda ou não
O generate_series cria a lista de dias, e a tabela de vendas entra com LEFT JOIN, para que o dia sem venda continue na resposta:
SELECT d::date AS dia,
       count(v.id) AS vendas,
       coalesce(sum(v.valor), 0) AS total
FROM generate_series(date '2026-11-01', date '2026-11-07', interval '1 day') AS d
LEFT JOIN venda v ON v.criada_em >= d AND v.criada_em < d + interval '1 day'
GROUP BY d
ORDER BY d;
Agora saíram as sete linhas, com 0 nos dias 1, 4 e 6. Três detalhes fazem diferença. O count(v.id), e não count(*): no dia vazio, o LEFT JOIN traz uma linha com a venda nula, e o count(*) contaria 1. O coalesce, porque a soma de nada é nula, e não zero. E a condição de data por intervalo (maior ou igual ao começo do dia, menor que o começo do seguinte), que pode usar um índice da coluna e não precisa converter cada linha para date.
Armadilha 1: o filtro no lugar errado
O pedido seguinte costuma ser “só as vendas acima de R$ 12”. Posto no WHERE, o filtro desfez o trabalho:
... LEFT JOIN venda v ON v.criada_em >= d AND v.criada_em < d + interval '1 day'
WHERE v.valor > 12
A resposta voltou a ter quatro dias. O WHERE roda depois da junção: no dia sem venda, v.valor é nulo, nulo > 12 não é verdadeiro, e a linha do dia sai. A condição sobre a tabela da direita de um LEFT JOIN vai no ON:
LEFT JOIN venda v ON v.criada_em >= d AND v.criada_em < d + interval '1 day'
                  AND v.valor > 12
Com ela no ON, voltaram os sete dias, e o dia 7 passou a ter uma venda em vez de duas, porque a de R$ 10 ficou de fora.
Armadilha 2: o fuso decide em que dia a venda caiu
O generate_series com datas devolve timestamp with time zone, e a meia-noite de cada dia é a do fuso da sessão. Uma das vendas do teste foi às 23h30 de 5 de novembro, em São Paulo. Com a sessão em America/Sao_Paulo, ela contou no dia 5. Com a sessão em UTC, o mesmo relatório pôs a venda no dia 6, porque em UTC já eram 2h30 do dia seguinte.
O relatório precisa dizer de qual fuso é o dia. Fixe o fuso da conexão (SET TIME ZONE, ou o parâmetro timezone do usuário do banco) com o da empresa, e guarde o instante em timestamptz, como explicamos no guia de timestamp e timestamptz.
Por semana e por mês
A mesma consulta serve para outras janelas, trocando o passo. Por semana, começando na segunda-feira:
SELECT s::date AS semana, count(v.id) AS vendas
FROM generate_series(date_trunc('week', date '2026-11-01'), date '2026-11-30', interval '1 week') AS s
LEFT JOIN venda v ON v.criada_em >= s AND v.criada_em < s + interval '1 week'
GROUP BY s ORDER BY s;
O date_trunc('week', ...) levou 1º de novembro, um domingo, para a segunda-feira anterior, 26 de outubro. A resposta teve seis semanas, com as seis vendas do teste na semana de 2 de novembro e zero nas outras. Por mês, o passo é interval '1 month', com o date_trunc('month', ...) no começo.
Um último cuidado: a lista de dias vem do generate_series, e não da tabela, então o intervalo pedido é o que aparece. Se a tela deixa a pessoa escolher o período, as duas datas da série são as do filtro dela, e a consulta mostra o período inteiro mesmo quando ele começa antes da primeira venda.
Fontes: Documentação do PostgreSQL: funções que devolvem conjuntos, Documentação do PostgreSQL: expressões de tabela e junções
Produzido com auxílio de IA e revisado pela redação.
Comentários (0)
Ainda não há comentários. Comece a conversa.
Deixe seu comentário